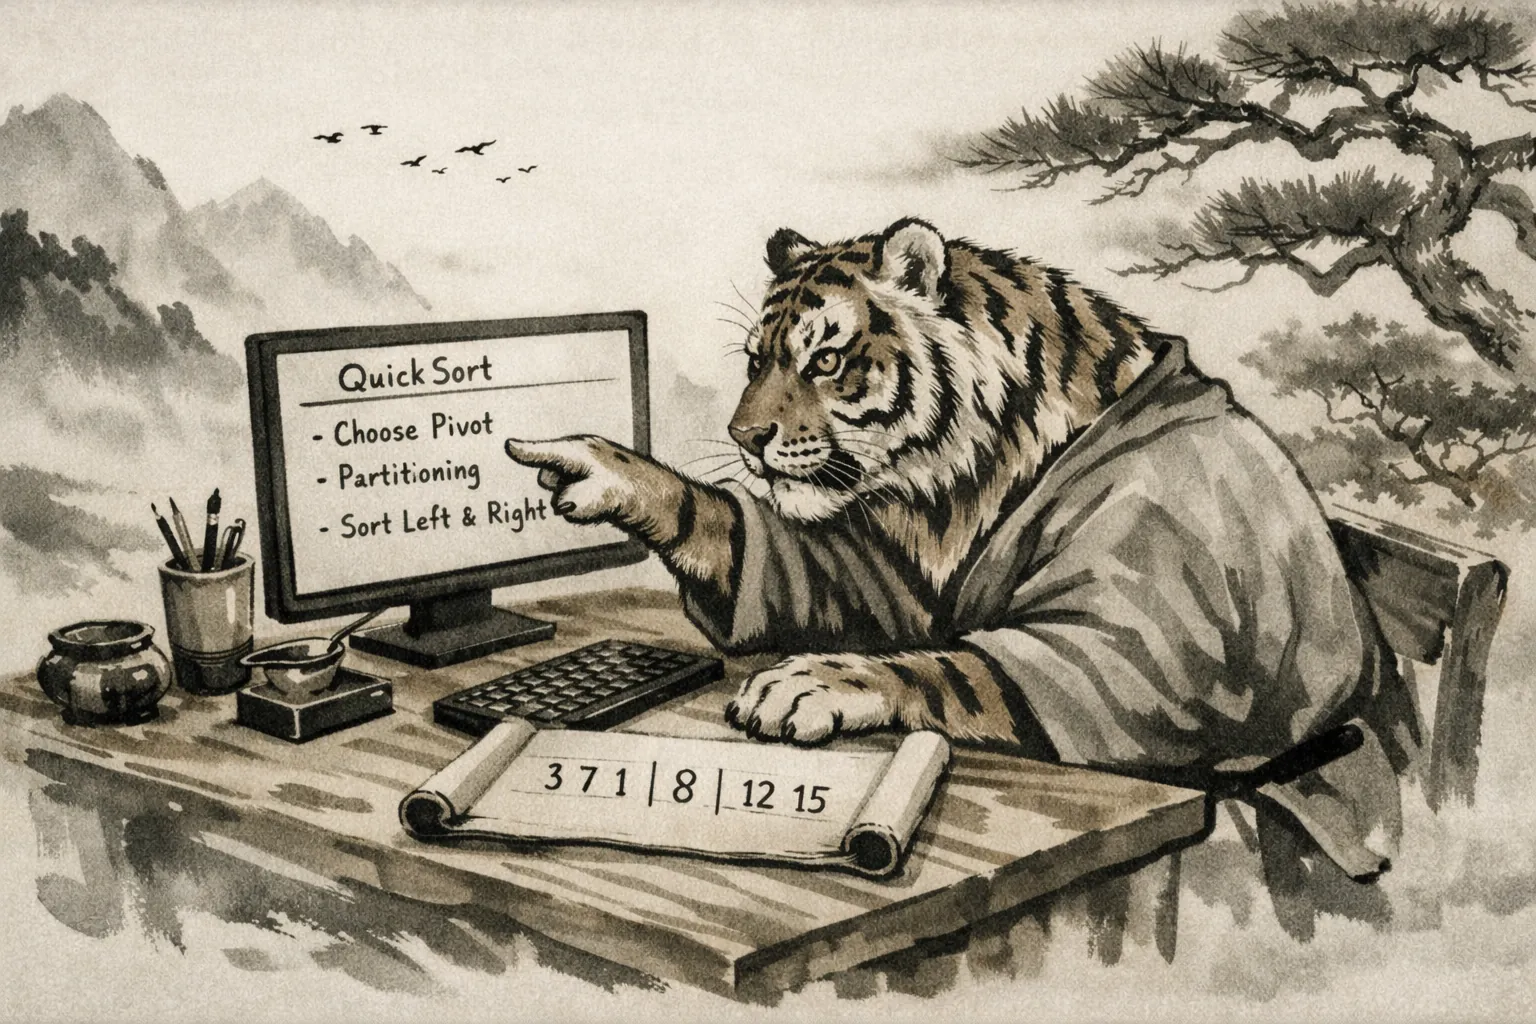
퀵 정렬(Quick Sort)은 분할 정복(Divide and Conquer) 전략을 사용하는 정렬 알고리즘으로, 평균적으로 가장 빠른 성능을 보인다. 피벗(pivot)을 기준으로 데이터를 분할하고 재귀적으로 정렬하는 방식으로, 실무에서 가장 많이 사용되는 정렬 알고리즘 중 하나다.
퀵 정렬이란?
퀵 정렬은 피벗(pivot)이라는 기준 값을 선택하여 피벗보다 작은 값은 왼쪽, 큰 값은 오른쪽으로 분할(partition) 한 후, 각 부분을 재귀적으로 정렬하는 알고리즘이다. 찰스 앤터니 리처드 호어(C.A.R. Hoare)가 1960년에 개발했고, 평균적으로 O(n log n)의 시간 복잡도를 가진다.
동작 원리
- 피벗 선택: 배열에서 피벗(기준 값)을 하나 선택
- 분할(Partition): 피벗보다 작은 값은 왼쪽, 큰 값은 오른쪽으로 재배치
- 재귀 정렬: 분할된 왼쪽 부분과 오른쪽 부분을 각각 재귀적으로 퀵 정렬
- 종료 조건: 부분 배열의 크기가 1 이하면 종료
퀵 정렬의 핵심은 분할(Partition) 과정이다. 피벗을 기준으로 배열을 효율적으로 재배치하는 것이 성능의 관건이다.
인터랙티브 애니메이션
위에서 설명한 퀵 정렬 과정을 직접 눈으로 확인한다. 시작 버튼을 누르면 정렬 과정을 단계별로 볼 수 있다.
- 보라색: 현재 피벗 (pivot)
- 파란색: 피벗보다 작은 값 (왼쪽 영역)
- 주황색: 피벗보다 큰 값 (오른쪽 영역)
- 노란색: 현재 비교 중인 요소
- 초록색: 정렬이 완료된 요소
- 회색: 아직 처리되지 않은 요소
- 속도를 조절하여 분할 과정을 천천히 확인할 수 있다.
- 재귀적으로 좌우 부분이 정렬되는 과정을 볼 수 있다.
복잡도 분석
시간 복잡도
| 경우 | 복잡도 | 설명 |
|---|---|---|
| 최선 (Best) | O(n log n) | 피벗이 항상 중간값일 때 |
| 평균 (Average) | O(n log n) | 일반적인 경우 |
| 최악 (Worst) | O(n²) | 피벗이 항상 최솟값 또는 최댓값일 때 |
계산 과정
평균 및 최선의 경우 (O(n log n)):
- 분할 단계: 배열을 피벗 기준으로 2개로 분할 → 재귀 깊이 log n
- 각 단계에서 n개의 원소 비교 → O(n)
- 총 시간 복잡도: O(n) × O(log n) = O(n log n)
왜 깊이가 log n인지는 n = 8로 따라가 보면 보인다. 피벗이 매번 정가운데에 오면 8개 → 4개 → 2개 → 1개로 세 번 나누면 끝난다. 8을 반으로 몇 번 나눠야 1이 되는지가 log 8 = 3이다. 그리고 같은 깊이에 있는 부분 배열들을 모두 합치면 언제나 원래 배열의 원소 n개다(8개를 4개 두 덩어리로, 다시 2개 네 덩어리로 나눴을 뿐이다). 그래서 깊이 하나마다 분할에서 비교하는 횟수를 다 더하면 n번쯤이고, 그런 깊이가 log n층 있으니 n × log n이 된다.
최악의 경우 (O(n²)):
- 이미 정렬된 배열에서 첫 번째 또는 마지막 원소를 피벗으로 선택
- 한쪽으로만 분할되어 재귀 깊이 n
- 총 시간 복잡도: O(n) × O(n) = O(n²)
- 예시: [1, 2, 3, 4, 5]에서 항상 마지막 원소를 피벗으로 선택
이 예시를 따라가 보면 이렇다. 첫 피벗은 5이고, 나머지 네 값이 전부 5보다 작아서 왼쪽에 [1, 2, 3, 4]가 남고 오른쪽은 빈다. 다음 피벗 4도 마찬가지로 [1, 2, 3]만 남긴다. 한 번 분할할 때마다 원소가 겨우 하나(피벗)씩 줄어드니, 원소 n개를 다 처리하려면 n번 가까이 내려가야 한다. 그리고 각 깊이에서 비교하는 횟수는 남은 원소 수인 4, 3, 2, 1번이다. 다 더하면 n + (n-1) + … + 1 = n(n+1)/2번이라 O(n²)이 된다.
중요한 특징:
- 평균적으로 병합 정렬보다 2~3배 빠름 (상수 계수가 작음). 이 배수는 원래 글에 근거 없이 적혀 있던 값이고, 나는 재 보지 않았다
- 피벗 선택 전략이 성능에 큰 영향을 미침
- CPU 캐시 효율성이 좋아 실전에서 매우 빠름
공간 복잡도
- 평균 O(log n): 재귀 호출 스택 공간
- 최악 O(n): 한쪽으로만 분할될 때 재귀 깊이 n
- 제자리 정렬(in-place sorting)이므로 추가 배열은 불필요. 위의 O(log n)은 배열이 아니라 재귀 호출 기록이 쌓이는 자리다
- 병합 정렬(O(n))보다 공간 효율적
장단점
장점
- 평균적으로 가장 빠르다: O(n log n)으로 실전에서 최고 성능
- 제자리 정렬: 추가 메모리가 거의 필요 없음 (O(log n) 스택만)
- 캐시 효율성: 참조 지역성(locality of reference)이 좋음. 분할은 배열을 양 끝에서 차례로 훑으므로, 방금 읽은 칸의 바로 옆 칸을 곧 다시 읽는다
- 병합 정렬보다 실전에서 빠름: 상수 계수가 작음
- 분할 정복: 병렬화하기 쉬움. 한 번 나눈 왼쪽과 오른쪽은 서로 겹치는 칸이 없어서, 두 부분을 서로 다른 CPU 코어(멀티코어 참고)에 맡겨도 서로를 기다릴 필요가 없다
- 범용성: 다양한 데이터 타입에 적용 가능
단점
- 최악의 경우 O(n²): 피벗 선택이 나쁘면 성능 저하
- 불안정 정렬(Unstable Sort): 같은 값의 순서가 보장되지 않음(정렬 안정성). 분할은 멀리 떨어진 두 칸을 맞바꾸기 때문에, 값이 같은 두 원소 중 앞에 있던 것이 이 교환에 휩쓸려 뒤로 갈 수 있다. 「이름순으로 정렬해 둔 명단을 다시 점수순으로 정렬」할 때처럼 앞선 정렬 결과를 지켜야 하면 문제가 된다
- 재귀적 구현: 깊은 재귀로 인한 스택 오버플로 가능
- 이미 정렬된 데이터에 취약: 피벗 선택 전략이 중요
- 작은 배열에 비효율적: 재귀 오버헤드. 원소가 몇 개 안 되면 정렬 자체보다 함수를 부르고 돌아오는 비용이 더 크다
피벗 선택 전략
피벗 선택은 퀵 정렬의 성능을 결정하는 가장 중요한 요소다.
1. 첫 번째/마지막 원소 (단순 방식)
def quick_sort_last_pivot(arr, low, high):
    """마지막 원소를 피벗으로 선택 (가장 단순)"""
    if low < high:
        pivot_idx = partition(arr, low, high)  # 마지막 원소 사용
        quick_sort_last_pivot(arr, low, pivot_idx - 1)
        quick_sort_last_pivot(arr, pivot_idx + 1, high)
한 줄씩 따라가기 — 파이썬은 자바처럼 중괄호 { }로 블록을 묶지 않고, 줄 끝의 콜론(:)과 들여쓰기로 “여기서부터 이 함수(또는 if문) 안쪽이다”를 표시한다. 콜론 다음 줄부터 같은 만큼 들여쓰기된 줄들이 하나의 블록이고, 들여쓰기가 줄어들면 그 블록이 끝난 것이다.
def quick_sort_last_pivot(arr, low, high):— 함수를 정의한다. 자바의void quickSortLastPivot(int[] arr, int low, int high) {와 같은 자리이고, 콜론 뒤부터 들여쓰기된 줄들이 이 함수의 몸통이다."""마지막 원소를 피벗으로 선택 (가장 단순)"""— 따옴표 세 개로 감싼 이 줄은 독스트링이다. 실행에는 영향이 없는 설명문이고, 이 글의 거의 모든 함수 첫 줄에 있다.if low < high:— low가 high보다 작을 때만, 즉 정렬할 원소가 둘 이상 남았을 때만 아래 블록을 실행한다.pivot_idx = partition(arr, low, high)— 배열을 피벗 기준으로 나누고, 피벗이 자리 잡은 인덱스를 돌려받는다.partition은 이 코드 블록에 없다. 아래 「분할(Partition) 기법」의lomuto_partition이 바로 이 함수이고, 이 섹션과 Quickselect 섹션의partition은 모두 그것을 가리킨다고 보고 읽는다.quick_sort_last_pivot(arr, low, pivot_idx - 1)— 피벗보다 왼쪽 구간을 같은 함수로 다시 정렬한다. 함수가 자기 자신을 부르는 이 모양이 재귀다.quick_sort_last_pivot(arr, pivot_idx + 1, high)— 피벗보다 오른쪽 구간도 같은 방식으로 정렬한다.
장점: 구현이 간단
단점: 정렬되거나 역순 배열에서 O(n²)
2. 랜덤 피벗 (Random Pivot)
import random

def partition_random(arr, low, high):
    """랜덤하게 피벗 선택"""
    # 랜덤 인덱스 선택하여 마지막과 교환
    random_idx = random.randint(low, high)
    arr[random_idx], arr[high] = arr[high], arr[random_idx]
    return partition(arr, low, high)
한 줄씩 따라가기
random_idx = random.randint(low, high)— low부터 high 사이의 정수 하나를 무작위로 뽑는다.arr[random_idx], arr[high] = arr[high], arr[random_idx]— 자바라면int temp = arr[random_idx]; arr[random_idx] = arr[high]; arr[high] = temp;처럼 임시 변수가 있어야 두 값을 맞바꿀 수 있다. 파이썬은 등호 오른쪽의arr[high], arr[random_idx]두 값을 먼저 다 계산해 둔 다음 왼쪽의 두 칸에 한꺼번에 나눠 담기 때문에, 임시 변수 없이 한 줄로 두 값을 맞바꿀 수 있다. 여기서는 무작위로 고른 인덱스의 값과 맨 끝 값을 맞바꾼다.return partition(arr, low, high)— 방금 맨 끝으로 옮겨 온 값을 피벗 삼아 원래의 분할 함수를 그대로 호출한다.
장점: 최악의 경우 확률적으로 회피
단점: 랜덤 함수 호출 오버헤드
3. 중간값 3개 (Median-of-Three)
def median_of_three(arr, low, high):
    """
    첫 번째, 중간, 마지막 원소 중 중간값을 피벗으로 선택
    가장 실용적인 방법
    """
    mid = (low + high) // 2

    # 세 값 정렬
    if arr[low] > arr[mid]:
        arr[low], arr[mid] = arr[mid], arr[low]
    if arr[low] > arr[high]:
        arr[low], arr[high] = arr[high], arr[low]
    if arr[mid] > arr[high]:
        arr[mid], arr[high] = arr[high], arr[mid]

    # 중간값을 high-1 위치로 이동
    arr[mid], arr[high - 1] = arr[high - 1], arr[mid]
    return arr[high - 1]
한 줄씩 따라가기
mid = (low + high) // 2— 배열 구간의 가운데 인덱스를 구한다(//는 나눈 몫만 남기고 소수점 아래를 버리는 정수 나눗셈이다).if arr[low] > arr[mid]: arr[low], arr[mid] = arr[mid], arr[low]— 첫 번째 값이 가운데 값보다 크면 둘을 맞바꾼다. 이 줄이 끝나면arr[low] <= arr[mid]가 보장된다.if arr[low] > arr[high]: arr[low], arr[high] = arr[high], arr[low]— 이제 첫 번째 값이 마지막 값보다도 크면 또 맞바꾼다. 이 줄이 끝나면arr[low]가 세 값 중 가장 작은 값이 된다.if arr[mid] > arr[high]: arr[mid], arr[high] = arr[high], arr[mid]— 남은 두 값(arr[mid],arr[high]) 중 큰 쪽을 마지막 자리로 보낸다. 세 번 비교·교환한 결과arr[low] <= arr[mid] <= arr[high]가 된다.arr[mid], arr[high - 1] = arr[high - 1], arr[mid]— 세 값 중 가운데 값(중간값)을high - 1위치로 옮겨 둔다. 분할 함수가 이 자리의 값을 피벗으로 쓸 것이기 때문이다. 다만 앞의partition(Lomuto)은arr[high]를 피벗으로 쓰므로 이 함수와 바로 맞물리지 않는다. 아래 「코드 구현」의 Median-of-Three 버전은 분할 함수가 이 자리를 받아 다시high로 옮긴 뒤 Lomuto 분할을 하게 해서 둘을 맞춘다.return arr[high - 1]—high - 1자리에 옮겨 둔 피벗 값을 돌려준다. 인덱스가 아니라 값이다. 아래 「코드 구현」의 Median-of-Three 버전은 같은 일을 하되return high - 1로 인덱스를 돌려주게 바꿔, 분할 함수가 그 자리를 바로 쓰게 했다.
장점: 좋은 피벗 선택 확률 높음
단점: 약간의 추가 비교 연산
4. 중간값 5개/9개 (Median-of-Medians)
제목의 「9개」에 해당하는 설명은 원래 글에 없다. 이 섹션은 5개씩 묶는 방법만 다룬다.
def median_of_medians(arr, low, high):
    """
    5개씩 그룹으로 나누어 중간값들의 중간값 선택
    최악의 경우도 O(n log n) 보장
    """
    # 구현 복잡도가 높아 실전에서는 잘 사용하지 않음
    # 주로 이론적 관심사
    pass
pass는 「여기서 아무것도 하지 않는다」는 파이썬 문법이다. 함수 몸통을 비워 둘 수 없어서 자리만 채운 것이고, 이 함수는 실제로는 구현되어 있지 않다.
장점: 최악의 경우도 O(n log n) 보장. 원소를 5개씩 묶어 각 묶음의 중간값을 구하고, 그 중간값들의 중간값을 피벗으로 고르면 피벗이 전체의 대략 30%~70% 사이 순위에 온다는 것이 알려져 있다. 한쪽이 거의 비는 분할이 생기지 않으니 깊이가 log n 수준으로 묶인다. 정확히 반씩이 아니어도 된다 — 큰 쪽이 많아야 70%라면 한 층 내려갈 때마다 구간이 0.7배 이하로 줄고, 0.7을 거듭 곱하면 반씩 줄일 때보다 몇 배 많은 층이 들 뿐 여전히 log n에 비례하는 층수 안에 1이 된다
단점: 구현 복잡, 실전에서 오버헤드가 큼
실무 권장사항: Median-of-Three가 가장 실용적이다.
분할(Partition) 기법
1. Lomuto Partition (단순하지만 느림)
def lomuto_partition(arr, low, high):
    """
    Lomuto 분할 기법 (교재에서 많이 사용)
    피벗: arr[high]
    """
    pivot = arr[high]
    i = low - 1  # 작은 값들의 마지막 인덱스

    for j in range(low, high):
        if arr[j] <= pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]

    # 피벗을 올바른 위치로
    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1
이 섹션의 lomuto_partition이 앞 섹션들에서 partition이라고 부르던 함수다.
한 줄씩 따라가기
pivot = arr[high]— 구간의 맨 끝 값을 피벗으로 쓴다.i = low - 1—i는 「피벗 이하 값들이 모인 구역의 마지막 칸」이다. 처음에는 그런 값이 하나도 없으니 구간 시작보다 한 칸 앞(low - 1)에서 시작한다.for j in range(low, high):—range(low, high)는low부터high - 1까지다. 끝 숫자는 포함하지 않는다. 자바의for (int j = low; j < high; j++)와 같고, 피벗이 있는high칸은 건드리지 않는다.if arr[j] <= pivot: i += 1; arr[i], arr[j] = ...— 피벗 이하 값을 만나면 그 구역을 한 칸 늘리고(i += 1), 늘어난 칸에 그 값을 옮겨 놓는다. 맞바꾸면서 원래arr[i]에 있던 값은j자리로 가는데, 그 값은 이미 본 칸 중 「피벗보다 큰 값」 구역의 맨 앞에 있던 것이라j쪽(큰 값 구역)으로 가도 괜찮다.i와j가 같은 칸이면 자기 자신과 바꾸는 셈이라 아무 일도 일어나지 않는다.arr[i + 1], arr[high] = arr[high], arr[i + 1]— 반복이 끝나면low~i에는 피벗 이하 값만,i + 1~high - 1에는 피벗보다 큰 값만 있다. 그러니 두 구역의 경계인i + 1이 피벗이 설 자리다. 그 칸과 맨 끝의 피벗을 맞바꾼다.return i + 1— 피벗이 자리 잡은 인덱스를 돌려준다.
특징:
- 구현이 직관적
- 중복 값이 많으면 비효율적. 피벗과 같은 값이 전부
<=쪽(왼쪽)으로 몰려서 분할이 한쪽으로 치우친다. 모든 값이 같으면 매번 한쪽만 남아 O(n²)이 된다 - 불필요한 교환이 많음. 위에서 본 대로
i와j가 같은 칸이면 자기 자신과 맞바꾸고, 피벗보다 큰 값 하나가 작은 값을 만날 때마다 한 칸씩 계속 뒤로 밀려 여러 번 옮겨진다
2. Hoare Partition (원조, 효율적)
def hoare_partition(arr, low, high):
    """
    Hoare 분할 기법 (원조, 더 효율적)
    양쪽에서 동시에 탐색
    """
    pivot = arr[low]
    i = low - 1
    j = high + 1

    while True:
        # 왼쪽에서 피벗보다 큰 값 찾기
        i += 1
        while arr[i] < pivot:
            i += 1

        # 오른쪽에서 피벗보다 작은 값 찾기
        j -= 1
        while arr[j] > pivot:
            j -= 1

        # 교차하면 종료
        if i >= j:
            return j

        # 교환
        arr[i], arr[j] = arr[j], arr[i]
한 줄씩 따라가기
pivot = arr[low]— 이번에는 구간의 맨 앞 값을 피벗으로 쓴다.i = low - 1,j = high + 1—i는 왼쪽 끝 바깥,j는 오른쪽 끝 바깥에서 출발한다. 반복 안에서 먼저 한 칸씩 움직이고 나서 보기 때문이다.while True:— 조건 없이 계속 도는 반복이다. 자바의while (true)와 같고, 안쪽의return j를 만나야 끝난다.i += 1뒤while arr[i] < pivot: i += 1— 왼쪽에서 오른쪽으로 가며 피벗 이상인 값을 만날 때까지i를 민다. 그 값은 왼쪽에 있으면 안 되는 값이다.j -= 1뒤while arr[j] > pivot: j -= 1— 오른쪽에서 왼쪽으로 가며 피벗 이하인 값을 만날 때까지j를 당긴다. 그 값은 오른쪽에 있으면 안 되는 값이다.if i >= j: return j— 두 손가락이 만나거나 엇갈렸으면,low~j에는 피벗 이하 값만,j + 1~high에는 피벗 이상 값만 남은 상태다. 그 경계j를 돌려준다.j는 피벗이 자리 잡은 칸이 아니라 두 구역의 경계일 뿐이다. 그래서 이 분할을 쓰는 퀵 정렬은j를 왼쪽 구역에 포함해(low, j)와(j + 1, high)로 재귀한다.arr[i], arr[j] = arr[j], arr[i]— 아직 엇갈리지 않았으면 서로 잘못된 쪽에 있던 두 값을 맞바꾸고 다시 찾는다.
특징:
- 교환 횟수가 적음 (Lomuto의 약 1/3). 이 비율은 원래 글에 출처 없이 적혀 있던 값이고, 나는 확인하지 않았다
- 구현이 약간 더 복잡
- 실전에서 더 빠름
3. Three-Way Partition (중복 값 처리)
def three_way_partition(arr, low, high):
    """
    3-way 분할 (Dijkstra's Dutch National Flag)
    중복 값이 많을 때 효율적
    [low...lt-1] < pivot, [lt...gt] == pivot, [gt+1...high] > pivot
    """
    pivot = arr[low]
    lt = low       # less than
    i = low + 1    # current
    gt = high      # greater than

    while i <= gt:
        if arr[i] < pivot:
            arr[lt], arr[i] = arr[i], arr[lt]
            lt += 1
            i += 1
        elif arr[i] > pivot:
            arr[i], arr[gt] = arr[gt], arr[i]
            gt -= 1
        else:  # arr[i] == pivot
            i += 1

    return lt, gt
한 줄씩 따라가기 — 이름의 Dutch National Flag는 네덜란드 국기 문제다. 값을 「피벗보다 작다 / 같다 / 크다」 세 묶음으로 나눈다.
- 독스트링의
[low...lt-1] < pivot, [lt...gt] == pivot, [gt+1...high] > pivot은 파이썬 문법이 아니라 설명용 표기다. 「인덱스low부터lt-1까지는 피벗보다 작은 값,lt부터gt까지는 피벗과 같은 값,gt+1부터high까지는 피벗보다 큰 값」이라는 뜻이다. 반복이 끝났을 때 배열이 이 모양이 된다. lt = low,i = low + 1,gt = high—lt는 「같은 값 구역의 시작」,i는 지금 보는 칸,gt는 「아직 안 본 구역의 끝」이다.while i <= gt:— 아직 안 본 칸이 남아 있는 동안 돈다.if arr[i] < pivot:— 작은 값이면 같은 값 구역의 맨 앞(lt)과 맞바꾸고lt와i를 둘 다 한 칸 민다. 이때i를 늘려도 되는 이유는lt자리에서 넘어온 값이 이미 본 「피벗과 같은 값」이기 때문이다(처음lt == low일 때는 피벗 자신이다).elif arr[i] > pivot:—elif는 자바의else if다. 큰 값이면 아직 안 본 구역의 맨 끝(gt)과 맞바꾸고gt만 한 칸 줄인다.i를 늘리지 않는 이유는gt자리에서 넘어온 값을 아직 한 번도 보지 않았기 때문이다. 다음 반복에서 같은i자리를 다시 본다.else: i += 1— 피벗과 같은 값이면 그 자리에 두고 다음 칸으로 간다.return lt, gt— 값 두 개를 튜플로 묶어 돌려준다. 자바라면new int[]{lt, gt}처럼 배열에 담아야 할 일이다(아래 자바 3-way 구현이 실제로 그렇게 한다).
사용:
def quick_sort_3way(arr, low, high):
    """3-way 퀵 정렬"""
    if low < high:
        lt, gt = three_way_partition(arr, low, high)
        quick_sort_3way(arr, low, lt - 1)
        quick_sort_3way(arr, gt + 1, high)
lt, gt = three_way_partition(arr, low, high)는 돌려받은 튜플의 두 값을 순서대로 lt와 gt에 나눠 담는다. 그 뒤 피벗과 같은 값 구역(lt~gt)은 이미 제자리이므로 빼고, 양옆만 재귀로 정렬한다.
장점: 중복 값이 많은 배열에서 성능 향상
실제 사용: Java의 Arrays.sort()는 기본 타입 배열(int[] 등)에 Dual-Pivot Quicksort를 쓴다. 이것도 배열을 세 구간으로 나누지만, 위의 3-way 분할과 같은 것은 아니다. 3-way는 피벗 하나로 「작다 / 같다 / 크다」를 나누고, Dual-Pivot은 피벗 두 개로 「작은 피벗보다 작다 / 두 피벗 사이 / 큰 피벗보다 크다」를 나눈다
다른 정렬 알고리즘과의 비교
퀵 정렬과 다른 주요 정렬 알고리즘의 특징을 비교한다. 표에 나오는 병합 정렬 · 힙 정렬 · 삽입 정렬은 용어 페이지에 한 줄씩 정리해 두었다. 「안정성」은 정렬 안정성을 말한다.
| 특성 | 퀵 정렬 | 병합 정렬 | 힙 정렬 | 삽입 정렬 |
|---|---|---|---|---|
| 평균 시간 | O(n log n) | O(n log n) | O(n log n) | O(n²) |
| 최악 시간 | O(n²) | O(n log n) | O(n log n) | O(n²) |
| 공간 복잡도 | O(log n) | O(n) | O(1) | O(1) |
| 안정성 | 불안정 | 안정 | 불안정 | 안정 |
| 제자리 정렬 | 예 | 아니오 | 예 | 예 |
| 캐시 효율성 | 높음 | 중간 | 낮음 | 높음 |
| 병렬화 | 쉬움 | 쉬움 | 어려움 | 어려움 |
| 실전 성능(5점 만점) | 5 | 4 | 3 | 1 |
표에서 퀵 정렬이 아닌 칸(힙 정렬의 캐시 효율성 「낮음」, 병렬화 「쉬움 / 어려움」 등)과 「실전 성능」 점수는 원래 글에 근거 없이 적혀 있던 것이다. 퀵 정렬 칸의 이유만 앞의 「장단점」에서 댔고, 나머지는 나는 확인하지 않았다.
왜 퀵 정렬이 실전에서 가장 빠른가?
- 캐시 효율성: 연속된 메모리 접근으로 CPU 캐시 히트율 높음(필요한 값이 캐시에 이미 있는 비율이 높다)
- 상수 계수: 병합 정렬보다 실제로 2~3배 빠름
- 제자리 정렬: 추가 메모리 할당 최소화
- 분기 예측: 현대 CPU의 분기 예측에 유리. 퀵 정렬이 왜 짐작을 잘 맞히게 하는지는 원래 글에 설명이 없고, 나도 확인하지 않았다
실제 성능 (1억 개 정수 정렬):
- 퀵 정렬:   2.5초
- 병합 정렬: 5.8초
- 힙 정렬:   8.2초
이 세 수치는 원래 글에 어떤 컴퓨터 · 언어 · 코드로 쟀는지 없이 적혀 있었다. 나는 측정 조건을 확인하지 못했으니 순서(퀵 < 병합 < 힙)를 보여 주는 예시로만 읽는다.
실무에서의 활용
1. 표준 라이브러리에서의 사용
퀵 정렬은 많은 프로그래밍 언어의 표준 정렬 함수의 기반이다. 표준 라이브러리는 언어가 기본으로 함께 주는 코드 묶음이다(라이브러리). 자바라면 java.util.Arrays의 Arrays.sort()가 그 정렬 함수다.
C/C++ qsort(), std::sort()
// Introsort 사용 (퀵 정렬 + 힙 정렬 하이브리드)
std::sort(arr.begin(), arr.end());
qsort()는 C 언어의 표준 정렬 함수이고, std::sort()는 C++ STL의 정렬 함수다. arr.begin()과 arr.end()는 「정렬할 범위의 시작과 끝」을 넘기는 C++ 방식이라, 자바의 Arrays.sort(arr)처럼 배열 전체를 정렬한다는 뜻으로 읽으면 된다. 주석의 Introsort는 아래 2번에서 다룬다. 주석이 말하는 Introsort는 std::sort() 쪽 이야기이고, qsort()가 실제로 어떤 알고리즘인지는 구현마다 달라서 나는 확인하지 않았다.
Java Arrays.sort()
// 기본 타입: Dual-Pivot Quicksort
// 객체: Timsort (병합 정렬 + 삽입 정렬)
Arrays.sort(arr);
자바는 배열 타입에 따라 정렬 방식을 가른다. int 같은 기본 타입은 값이 같으면 구별할 방법이 없어서, 같은 값끼리 순서가 바뀌어도 결과가 똑같다. 그래서 불안정해도 빠른 퀵 정렬 계열을 쓴다. 객체는 「값은 같지만 다른 객체」가 있을 수 있어서 순서가 지켜져야 하므로, 안정 정렬인 Timsort를 쓴다.
Python sorted(), list.sort()
# Timsort (병합 정렬 + 삽입 정렬)
# 안정 정렬이 필요하여 퀵 정렬 대신 Timsort 사용
sorted(arr)
sorted(arr)는 원래 리스트는 그대로 두고 정렬된 새 리스트를 돌려준다. arr.sort()는 원래 리스트 자체를 정렬한다. 파이썬은 언어 차원에서 두 함수 모두 안정 정렬이라고 약속하고 있어서, 이 약속을 지키려고 퀵 정렬 대신 Timsort를 쓴다.
2. Introsort (Introspective Sort)
실전에서 가장 많이 사용되는 하이브리드 알고리즘:
import math

def introsort(arr):
    """
    Introsort: 퀵 정렬 + 힙 정렬 + 삽입 정렬
    C++ std::sort()의 실제 구현
    """
    max_depth = 2 * math.floor(math.log2(len(arr)))
    introsort_helper(arr, 0, len(arr) - 1, max_depth)

def introsort_helper(arr, low, high, max_depth):
    size = high - low + 1

    # 작은 배열: 삽입 정렬
    if size <= 16:
        insertion_sort_range(arr, low, high)
        return

    # 재귀 깊이 초과: 힙 정렬
    if max_depth == 0:
        heapsort_range(arr, low, high)
        return

    # 기본: 퀵 정렬 (Median-of-Three)
    pivot_idx = partition_median_of_three(arr, low, high)
    introsort_helper(arr, low, pivot_idx - 1, max_depth - 1)
    introsort_helper(arr, pivot_idx + 1, high, max_depth - 1)
한 줄씩 따라가기
math.log2(len(arr))— 배열 길이의 밑이 2인 로그값을 구한다. 예를 들어 배열 길이가 16이면log2(16)은 4다(2를 네 번 곱해야 16이 되기 때문이다) — 이것이 바로 완전히 반으로만 계속 쪼갰을 때(최선의 경우) 퀵 정렬이 재귀하는 깊이다. 아래 「두 배」는 이 최선의 깊이를 기준으로 한 말이다.math.floor(...)— 소수점 아래를 버리고 정수로 만든다. 배열 길이가 2의 거듭제곱이 아니면log2결과가 소수로 나오기 때문이다.2 * ...— 그 깊이의 두 배를 재귀 허용 한도(max_depth)로 잡는다. 가장 잘 나뉠 때의 깊이(log2 n)보다 두 배 더 깊이 들어가도 괜찮다는 여유를 둔 것이고, 재귀를 거듭해 이 한도를 다 쓰면(introsort_helper에서max_depth == 0이 되면) 피벗이 계속 나쁘게 뽑혀 최악의 경우에 가까워졌다고 보고 힙 정렬로 바꾼다.introsort_helper(arr, 0, len(arr) - 1, max_depth)— 전체 배열 범위와 방금 구한 깊이 한도를 들고 실제 정렬을 시작한다.size = high - low + 1— 지금 맡은 구간의 원소 개수다.if size <= 16: insertion_sort_range(...); return— 원소가 16개 이하로 작아지면 더 나누지 않고 삽입 정렬로 끝낸다. 작은 배열에서는 재귀 오버헤드가 정렬보다 비싸기 때문이다. 16은 GCC(리눅스에서 많이 쓰는 C/C++ 컴파일러와 그 표준 라이브러리 묶음)의std::sort구현이 쓰는 경계값으로 알려져 있는데, 나는 소스를 직접 열어 확인하지 않았다.if max_depth == 0: heapsort_range(...); return— 깊이 한도를 다 썼으면 이 구간은 힙 정렬로 마무리한다.- 나머지 세 줄 — 그 밖의 경우에는 Median-of-Three로 피벗을 골라 분할하고, 한도를 1 줄인 채(
max_depth - 1) 양쪽을 재귀로 정렬한다.
이 코드의 insertion_sort_range · heapsort_range · partition_median_of_three는 이 글에 같은 이름으로 정의되어 있지 않다. 이름 그대로 「구간을 삽입 정렬 / 힙 정렬한다」, 「Median-of-Three로 피벗을 골라 분할하고 피벗 자리를 돌려준다」고 보고 읽는다. insertion_sort_range는 아래 「코드 구현」의 하이브리드 버전 안에 같은 일을 하는 함수가 있다.
특징:
- 퀵 정렬의 빠른 평균 성능
- 힙 정렬로 최악의 경우 방어 → O(n log n) 보장
- 삽입 정렬로 작은 배열 최적화
- C++ STL의
std::sort()실제 구현
3. k번째 작은 원소 찾기 (Quickselect)
퀵 정렬의 분할을 이용한 선택 알고리즘:
def quickselect(arr, k):
    """
    배열에서 k번째로 작은 원소 찾기
    평균 O(n), 최악 O(n²)
    """
    def select(arr, low, high, k):
        if low == high:
            return arr[low]

        # 분할
        pivot_idx = partition(arr, low, high)

        # k번째 원소의 위치 확인
        if k == pivot_idx:
            return arr[k]
        elif k < pivot_idx:
            return select(arr, low, pivot_idx - 1, k)
        else:
            return select(arr, pivot_idx + 1, high, k)

    return select(arr, 0, len(arr) - 1, k)

# 사용 예시
arr = [7, 10, 4, 3, 20, 15]
print(f"3번째로 작은 원소: {quickselect(arr, 2)}")  # 7 (0-indexed)
이 코드의 k는 0부터 센 자리다(주석의 0-indexed). 그래서 「3번째로 작은 원소」를 찾으려면 k = 2를 넘긴다. 정렬했을 때 인덱스 k에 올 값을 찾는다고 보면 된다.
한 줄씩 따라가기
def select(arr, low, high, k):— quickselect 내부에 정의된 도우미 함수다. 피벗으로 나눈 뒤 k번째 원소가 어느 쪽에 있는지 보고 그쪽만 다시 뒤진다.if low == high: return arr[low]— 구간에 원소가 하나만 남으면 그게 답이다.pivot_idx = partition(arr, low, high)— 평소처럼 배열을 피벗 기준으로 나눈다.if k == pivot_idx: return arr[k]— 찾던 k번째 자리에 마침 피벗이 왔으면 바로 그 값이 답이다.elif k < pivot_idx: return select(arr, low, pivot_idx - 1, k)— k가 피벗보다 왼쪽에 있으면 왼쪽 구간만 재귀로 다시 찾는다.else: return select(arr, pivot_idx + 1, high, k)— 오른쪽에 있으면 오른쪽 구간만 찾는다. 퀵 정렬과 달리 양쪽을 다 재귀하지 않고 한쪽만 재귀하므로 평균 O(n)이 된다. 피벗이 대략 가운데에 온다고 치면 처음 분할에서 n번, 다음에는 남은 절반에서 n/2번, 그다음 n/4번을 비교한다. n + n/2 + n/4 + … 는 아무리 더해도 2n을 넘지 않으므로 O(n)이다. 퀵 정렬은 양쪽을 다 내려가서 깊이마다 n번씩 log n층이 쌓이지만, 여기서는 층마다 일이 절반으로 준다.print(f"3번째로 작은 원소: {quickselect(arr, 2)}")— 파이썬의 f-string 문법이다. 문자열 앞에f를 붙이면 문자열 안의 중괄호{ }에 변수나 식을 넣어 그 결과값으로 바꿔 끼워 넣을 수 있다. 자바의"3번째로 작은 원소: " + quickselect(arr, 2)처럼 문자열과 값을 이어 붙이는 것과 같은 역할이다. 여기서는quickselect(arr, 2)의 결과(인덱스 2, 즉 0부터 세어 세 번째로 작은 값)를 문자열에 끼워 넣어 출력한다.
응용:
- 중앙값(median) 찾기:
quickselect(arr, len(arr) // 2) - 백분위수(percentile) 계산 — 「하위 90%에 해당하는 값」은 정렬했을 때 90% 지점 인덱스에 올 값이라, 그 인덱스를
k로 넘기면 된다 - Top-K 문제 — 「가장 큰 K개」를 찾는 문제. 아래 실전 문제의 예제 3이 이 모양이다
최적화 기법
1. 작은 배열은 삽입 정렬
CUTOFF = 10  # 임계값

def hybrid_quick_sort(arr, low, high):
    """작은 부분 배열은 삽입 정렬 사용"""
    if high - low + 1 <= CUTOFF:
        insertion_sort_range(arr, low, high)
    elif low < high:
        pivot_idx = partition(arr, low, high)
        hybrid_quick_sort(arr, low, pivot_idx - 1)
        hybrid_quick_sort(arr, pivot_idx + 1, high)
insertion_sort_range는 이 블록에 없고, 아래 「코드 구현」의 하이브리드 버전에 정의되어 있다. 구간 원소 수(high - low + 1)가 CUTOFF 이하면 삽입 정렬로 끝내고, 아니면 평소처럼 분할한다.
효과: 재귀 오버헤드 감소, 5~15% 성능 향상. 이 비율과 CUTOFF = 10(앞의 Introsort는 16)은 원래 글에 근거 없이 적혀 있던 값이고, 나는 재 보지 않았다. 어느 쪽이든 「작은 구간은 삽입 정렬」이라는 생각은 같다
2. 꼬리 재귀 최적화 (Tail Recursion)
def quick_sort_tail_optimized(arr, low, high):
    """
    꼬리 재귀 최적화로 스택 사용량 감소
    항상 작은 부분부터 재귀, 큰 부분은 반복
    """
    while low < high:
        # 분할
        pivot_idx = partition(arr, low, high)

        # 작은 부분을 재귀 (스택 사용 최소화)
        if pivot_idx - low < high - pivot_idx:
            quick_sort_tail_optimized(arr, low, pivot_idx - 1)
            low = pivot_idx + 1
        else:
            quick_sort_tail_optimized(arr, pivot_idx + 1, high)
            high = pivot_idx - 1
꼬리 재귀는 함수가 마지막에 자기 자신을 부르는 것 말고는 할 일이 없는 재귀다. 그런 재귀 한 번은 「매개변수를 바꾸고 처음으로 돌아가기」로 바꿀 수 있다.
한 줄씩 따라가기
while low < high:— 재귀의if low < high:자리에 반복문을 둔다.if pivot_idx - low < high - pivot_idx:— 왼쪽 구간이 오른쪽보다 작은지 본다.- 작은 쪽은
quick_sort_tail_optimized(...)로 재귀 호출한다. - 큰 쪽은 재귀하지 않고
low = pivot_idx + 1(또는high = pivot_idx - 1)로 구간만 바꾼 뒤while의 처음으로 돌아가 다시 분할한다. 이 한 줄이 재귀 호출 한 번을 대신한다.
재귀로 들어가는 쪽은 언제나 작은 쪽이라, 들어갈 때마다 구간 크기가 절반 이하로 준다. n을 절반씩 줄이면 log n번 만에 1이 되므로, 쌓이는 호출도 최대 log n개다.
효과:
- 스택 깊이를 O(log n)으로 보장
- 스택 오버플로 방지
3. 반복적 구현 (Iterative)
def quick_sort_iterative(arr):
    """
    스택을 이용한 반복적 퀵 정렬
    재귀 대신 명시적 스택 사용
    """
    stack = [(0, len(arr) - 1)]

    while stack:
        low, high = stack.pop()

        if low < high:
            pivot_idx = partition(arr, low, high)

            # 양쪽 부분을 스택에 추가
            stack.append((low, pivot_idx - 1))
            stack.append((pivot_idx + 1, high))

    return arr
한 줄씩 따라가기
stack = [(0, len(arr) - 1)]— 「아직 정렬해야 할 구간」을 담는 리스트를 만든다. 구간 하나는(low, high)두 값을 묶은 튜플이고, 처음에는 배열 전체 구간 하나만 넣는다.while stack:— 파이썬은 리스트가 비어 있으면 거짓, 하나라도 있으면 참으로 친다. 자바의while (!stack.isEmpty())와 같다.low, high = stack.pop()—pop()은 리스트의 맨 뒤 원소를 꺼낸다. 꺼낸 튜플의 두 값을low와high에 나눠 담는다.stack.append(...)두 줄 — 분할한 양쪽 구간을 리스트 맨 뒤에 넣는다. 재귀 호출 두 번을 「나중에 할 일 목록에 적어 두기」로 바꾼 것이다.
장점: 재귀 호출 오버헤드 없음, 스택 오버플로 없음. 함수 호출 기록이 쌓이는 호출 스택은 크기 한도가 작다. 여기서는 할 일을 호출 스택이 아니라 보통의 리스트에 쌓으므로, 그 한도에 걸리지 않는다. 대신 리스트가 메모리를 쓴다
언제 사용해야 할까?
적합한 경우
- 대용량 데이터: 1000개 이상
- 평균 성능이 중요: 일반적인 데이터
- 메모리가 제한적: 제자리 정렬 필요
- 실전 속도 우선: 캐시 효율성 중요
- 병렬 처리: 멀티코어 활용 가능
- 재귀 깊이 문제없음: 스택 크기 충분
부적합한 경우
- 최악의 경우 방어 필수: 병합 정렬이나 힙 정렬 사용
- 안정 정렬 필요: 병합 정렬이나 Timsort 사용
- 거의 정렬된 데이터: 삽입 정렬이나 Timsort가 더 빠름. 삽입 정렬은 원소마다 한두 번 비교하면 자리가 정해지고, Timsort는 이미 정렬된 구간을 찾아 그대로 쓰기 때문이다
- 작은 데이터: 삽입 정렬이 더 간단하고 빠름
- 재귀 금지 환경: 반복적 구현 또는 다른 알고리즘. 호출 스택이 아주 작아서 재귀를 깊게 쓸 수 없는 환경을 말한다
알고리즘 선택 가이드
아래 개수 경계(10 · 50 · 1000)와 위의 「1000개 이상」은 원래 글에 근거 없이 적혀 있던 값이다. 나는 재 보지 않았으니 대략의 감으로만 읽는다.
데이터 크기와 조건에 따른 권장사항:

1. 매우 작음 (< 10개)      → 삽입 정렬
2. 작음 (10~50개)          → 삽입 정렬 or 퀵 정렬
3. 중간 (50~1000개)        → 퀵 정렬
4. 큼 (> 1000개)           → Introsort (퀵+힙+삽입)
5. 거의 정렬됨             → Timsort or 삽입 정렬
6. 안정 정렬 필요          → 병합 정렬 or Timsort
7. 최악 케이스 방어 필요   → 힙 정렬 or 병합 정렬
8. 메모리 제한             → 퀵 정렬 or 힙 정렬
실전 문제 연습
퀵 정렬은 코딩 테스트에서 구현 문제뿐만 아니라 응용 문제로도 자주 나온다. 아래 예제마다 붙은 「LeetCode 75」 같은 번호는 문제 사이트 LeetCode의 문제 번호다.
예제 1: 색깔별 정렬 (Dutch National Flag)
def sort_colors(nums):
    """
    0(빨강), 1(흰색), 2(파랑)을 정렬
    LeetCode 75. Sort Colors
    """
    red = 0     # 빨강 영역의 끝
    white = 0   # 현재 처리 중
    blue = len(nums) - 1  # 파랑 영역의 시작

    while white <= blue:
        if nums[white] == 0:
            nums[red], nums[white] = nums[white], nums[red]
            red += 1
            white += 1
        elif nums[white] == 1:
            white += 1
        else:  # nums[white] == 2
            nums[white], nums[blue] = nums[blue], nums[white]
            blue -= 1

    return nums

# 테스트
print(sort_colors([2, 0, 2, 1, 1, 0]))  # [0, 0, 1, 1, 2, 2]
이 문제는 앞의 3-way 분할을 피벗 1로 한 번 돌린 것과 같다. red가 3-way의 lt, white가 i, blue가 gt 자리다. 0을 만나면 앞 구역과 맞바꾸고 둘 다 한 칸 밀고, 1이면 그냥 지나가고, 2를 만나면 뒤 구역과 맞바꾸되 넘어온 값을 아직 안 봤으니 white는 그대로 둔다.
예제 2: k번째로 큰 원소
def find_kth_largest(nums, k):
    """
    k번째로 큰 원소 찾기
    LeetCode 215. Kth Largest Element
    """
    def partition(arr, low, high):
        pivot = arr[high]
        i = low - 1

        for j in range(low, high):
            if arr[j] >= pivot:  # 내림차순
                i += 1
                arr[i], arr[j] = arr[j], arr[i]

        arr[i + 1], arr[high] = arr[high], arr[i + 1]
        return i + 1

    def quickselect(arr, low, high, k):
        if low <= high:
            pivot_idx = partition(arr, low, high)

            if pivot_idx == k - 1:
                return arr[pivot_idx]
            elif pivot_idx > k - 1:
                return quickselect(arr, low, pivot_idx - 1, k)
            else:
                return quickselect(arr, pivot_idx + 1, high, k)

    return quickselect(nums, 0, len(nums) - 1, k)

# 테스트
print(find_kth_largest([3, 2, 1, 5, 6, 4], 2))  # 5
- 안쪽
partition은 Lomuto 분할에서 비교만<=를>=로 바꿨다. 피벗 이상인 값을 앞으로 모으므로, 큰 값이 앞에 오는 내림차순 분할이 된다. - 내림차순으로 놓으면 「k번째로 큰 값」은 0부터 센 인덱스
k - 1에 온다. 그래서pivot_idx == k - 1이면 답을 찾은 것이다. if low <= high:뒤에else가 없다. 파이썬 함수가return없이 끝나면None(자바의null)을 돌려준다. 다만k가 배열 길이 안에 있으면 그 전에 반드시pivot_idx == k - 1을 만나므로 이 경우는 생기지 않는다.
예제 3: Top K 빈도수 원소
from collections import Counter

def top_k_frequent(nums, k):
    """
    가장 빈도가 높은 k개의 원소
    LeetCode 347. Top K Frequent Elements
    """
    # 빈도수 계산
    count = Counter(nums)
    unique = list(count.keys())

    def partition(arr, low, high):
        pivot_freq = count[arr[high]]
        i = low - 1

        for j in range(low, high):
            if count[arr[j]] >= pivot_freq:  # 빈도수 내림차순
                i += 1
                arr[i], arr[j] = arr[j], arr[i]

        arr[i + 1], arr[high] = arr[high], arr[i + 1]
        return i + 1

    def quickselect(arr, low, high, k):
        if low <= high:
            pivot_idx = partition(arr, low, high)

            if pivot_idx == k - 1:
                return
            elif pivot_idx > k - 1:
                quickselect(arr, low, pivot_idx - 1, k)
            else:
                quickselect(arr, pivot_idx + 1, high, k)

    quickselect(unique, 0, len(unique) - 1, k)
    return unique[:k]

# 테스트
print(top_k_frequent([1, 1, 1, 2, 2, 3], 2))  # [1, 2]
from collections import Counter— 파이썬 표준 묶음collections에서Counter만 가져온다. 자바의import java.util.HashMap;과 비슷한 줄이다.count = Counter(nums)— 리스트의 값마다 몇 번 나왔는지 세어 「값 → 횟수」 지도를 만든다.[1, 1, 1, 2, 2, 3]이면{1: 3, 2: 2, 3: 1}이다. 자바로 치면Map<Integer, Integer>를 직접 세어 채운 것과 같다.unique = list(count.keys())— 지도의 키(서로 다른 값들)만 뽑아 리스트로 만든다. 정렬 대상은 이 리스트다.count[arr[high]]— 지도에서 그 값의 횟수를 꺼낸다. 자바의count.get(arr[high])다. 안쪽 함수partition은count를 매개변수로 받지 않았는데도 쓴다. 파이썬은 함수 안에 정의한 함수가 바깥 함수의 변수를 그대로 읽을 수 있어서다. 자바 메서드끼리는 이렇게 못 하고, 람다가 바깥 지역 변수를 읽는 것과 비슷하다.partition과quickselect— 예제 2와 같은 모양이고, 값 대신 횟수로 비교해 많이 나온 값을 앞으로 모은다. 찾는 것이 값 하나가 아니라 「앞에서 k개」라서,pivot_idx == k - 1이 되는 순간 값 없이return만 해서 멈춘다. 그때 리스트 앞 k칸에 가장 많이 나온 k개가 모여 있다.return unique[:k]— 슬라이싱으로 앞에서 k개를 잘라 돌려준다.
예제 4: 지그재그 정렬 (Wiggle Sort)
def wiggle_sort(nums):
    """
    배열을 지그재그로 정렬: nums[0] <= nums[1] >= nums[2] <= nums[3]...
    LeetCode 280. Wiggle Sort
    """
    for i in range(len(nums) - 1):
        if (i % 2 == 0 and nums[i] > nums[i + 1]) or \
           (i % 2 == 1 and nums[i] < nums[i + 1]):
            nums[i], nums[i + 1] = nums[i + 1], nums[i]

    return nums

# 테스트
print(wiggle_sort([3, 5, 2, 1, 6, 4]))  # [3, 5, 1, 6, 2, 4] (가능한 답 중 하나)
원래 이 예제의 제목이 「배열 분할 (Partition Labels)」이었는데, 코드는 LeetCode 280 Wiggle Sort라서 제목을 코드에 맞게 고쳤다. 이 코드는 퀵 정렬의 분할을 쓰지 않는다. 이웃한 두 칸을 비교해 맞바꾸는 방식이라 「자리 바꾸기로 배열을 원하는 모양으로 만든다」는 점만 닮았다.
for i in range(len(nums) - 1):— 마지막 칸 바로 앞까지 돈다.(i % 2 == 0 and nums[i] > nums[i + 1]) or (i % 2 == 1 and nums[i] < nums[i + 1])—and는 자바의&&,or는||다. 짝수 칸은 다음 칸보다 작거나 같아야 하고 홀수 칸은 다음 칸보다 크거나 같아야 하는데, 그 규칙을 어겼으면 참이다.- 줄 끝의
\— 한 줄이 길어서 다음 줄로 이어 쓴다는 표시다. 두 줄이 한 줄로 읽힌다. nums[i], nums[i + 1] = nums[i + 1], nums[i]— 규칙을 어긴 두 칸을 맞바꾼다.
맞바꾸면 앞에서 맞춰 둔 i-1과 i 사이 규칙이 깨지지 않을까. 깨지지 않는다. 짝수 칸 i에서 바꾸는 경우 nums[i]에는 원래보다 작은 값이 들어오는데, 그 앞 i-1(홀수 칸)은 원래 nums[i] 이상이어야 했으니 더 작은 값보다도 당연히 크거나 같다. 홀수 칸에서 바꾸는 경우는 큰 값이 들어오고, 그 앞 짝수 칸은 원래 값 이하였으니 더 큰 값보다도 작거나 같다. 그래서 왼쪽에서 오른쪽으로 한 번만 훑으면 끝난다.
디버깅 팁
1. 단계별 출력
def quick_sort_debug(arr, low, high, depth=0):
    """정렬 과정을 출력하는 디버깅 버전"""
    indent = "  " * depth

    if low < high:
        print(f"{indent}정렬 범위: arr[{low}:{high+1}] = {arr[low:high+1]}")

        # 분할
        pivot_idx = partition_debug(arr, low, high, depth)
        print(f"{indent}피벗 위치: {pivot_idx}, 값: {arr[pivot_idx]}")
        print(f"{indent}분할 후: {arr[low:high+1]}")

        # 재귀
        quick_sort_debug(arr, low, pivot_idx - 1, depth + 1)
        quick_sort_debug(arr, pivot_idx + 1, high, depth + 1)
    else:
        print(f"{indent}종료: arr[{low}:{high+1}] = {arr[low:high+1] if low <= high else []}")

def partition_debug(arr, low, high, depth):
    """분할 과정을 출력"""
    indent = "  " * depth
    pivot = arr[high]
    print(f"{indent}피벗: {pivot}")

    i = low - 1
    for j in range(low, high):
        if arr[j] <= pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]
            print(f"{indent}  교환: {arr[i]} ↔ {arr[j]}")

    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1

# 테스트
arr = [5, 3, 8, 4, 2]
print("=== 퀵 정렬 디버깅 ===")
quick_sort_debug(arr, 0, len(arr) - 1)
print(f"\n최종 결과: {arr}")
depth=0— 매개변수의 기본값이다. 호출할 때depth를 안 넘기면 0이 들어간다. 자바에는 이 문법이 없어서 보통 매개변수가 하나 적은 메서드를 따로 만든다." " * depth— 문자열에 숫자를 곱하면 그 문자열을 그만큼 이어 붙인다.depth가 2면 공백 네 칸이다. 재귀가 깊어질수록 출력이 오른쪽으로 들여 써져서 어느 깊이의 출력인지 보인다.arr[low:high+1]— 슬라이싱이다. 끝 인덱스는 포함하지 않으므로high까지 보려고high+1을 쓴다.arr[low:high+1] if low <= high else []— 파이썬의 한 줄 if/else 식(삼항 연산자)이다. 자바의low <= high ? ... : 빈 리스트와 같다.f"..."— f-string이다. 중괄호 안의 값이 문자열에 끼워진다.
2. 경계 조건 체크
def quick_sort_safe(arr, low, high):
    """안전한 경계 조건 체크"""
    # 경계 확인
    if arr is None:
        raise ValueError("배열이 None입니다")
    if low < 0 or high >= len(arr):
        raise IndexError(f"인덱스 범위 오류: low={low}, high={high}, len={len(arr)}")

    if low < high:
        pivot_idx = partition(arr, low, high)
        quick_sort_safe(arr, low, pivot_idx - 1)
        quick_sort_safe(arr, pivot_idx + 1, high)
arr is None— 파이썬의None은 자바의null이고,is None은 자바의arr == null과 같은 검사다.raise ValueError(...)—raise는 자바의throw다.ValueError와IndexError는 파이썬이 기본으로 가진 예외 종류로, 자바의IllegalArgumentException과IndexOutOfBoundsException자리라고 보면 된다.
마무리
퀵 정렬은 실무에서 가장 널리 사용되는 정렬 알고리즘이다. 평균적으로 O(n log n)의 빠른 성능과 제자리 정렬의 메모리 효율성을 갖추고 있어, 많은 언어의 표준 라이브러리 정렬이 퀵 정렬을 바탕으로 한다(C++ std::sort, 자바의 기본 타입 배열 정렬). 다만 앞에서 본 대로 자바의 객체 배열 정렬과 파이썬은 안정 정렬이 필요해서 Timsort를 쓴다.
핵심 요약
- 분할 정복 전략으로 평균 O(n log n) 성능
- 피벗 선택이 성능의 핵심 (Median-of-Three 권장)
- 제자리 정렬로 공간 복잡도 O(log n)
- 불안정 정렬이지만 실전에서 가장 빠름
- 최악의 경우 O(n²) 방어가 중요 (Introsort)
- Quickselect: k번째 원소 찾기에 응용
- 하이브리드 알고리즘: 작은 배열은 삽입 정렬
- 실무 표준: C++ STL, Java Arrays.sort() 등에서 사용
다음 학습 추천
퀵 정렬을 이해했다면, 다음 주제로:
- 병합 정렬(Merge Sort): 안정적인 O(n log n), 분할 정복
- 힙 정렬(Heap Sort): 최악의 경우에도 O(n log n) 보장
- Introsort: 퀵+힙+삽입 하이브리드 (C++ STL 실제 구현)
- Timsort: 병합+삽입 하이브리드 (Python 기본 정렬)
- 기수 정렬(Radix Sort): O(nk) 비-비교 정렬
을 학습하여 정렬 알고리즘의 전체적인 이해도를 높이는 것을 추천한다.
코드 구현
Python 구현
아래 함수들의 독스트링 안에 있는 Args:와 Returns:는 각각 매개변수와 반환값을 적는 관례적인 모양이다. 자바 Javadoc의 @param · @return과 같은 역할이고, 실행에는 영향이 없다.
기본 버전 (Lomuto Partition)
def quick_sort(arr):
    """
    퀵 정렬 기본 구현 (Lomuto Partition)

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    def partition(arr, low, high):
        """배열을 피벗 기준으로 분할"""
        pivot = arr[high]  # 마지막 원소를 피벗으로
        i = low - 1        # 작은 값들의 마지막 인덱스

        for j in range(low, high):
            if arr[j] <= pivot:
                i += 1
                arr[i], arr[j] = arr[j], arr[i]

        # 피벗을 올바른 위치로
        arr[i + 1], arr[high] = arr[high], arr[i + 1]
        return i + 1

    def quick_sort_helper(arr, low, high):
        """재귀적으로 정렬"""
        if low < high:
            # 분할
            pivot_idx = partition(arr, low, high)

            # 좌우 재귀 정렬
            quick_sort_helper(arr, low, pivot_idx - 1)
            quick_sort_helper(arr, pivot_idx + 1, high)

    quick_sort_helper(arr, 0, len(arr) - 1)
    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2, 7, 1, 10]
print(f"정렬 전: {numbers}")
quick_sort(numbers)
print(f"정렬 후: {numbers}")
Hoare Partition 버전
def quick_sort_hoare(arr):
    """
    퀵 정렬 (Hoare Partition)
    더 효율적인 분할 방식

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    def hoare_partition(arr, low, high):
        """Hoare의 분할 방식"""
        pivot = arr[low]
        i = low - 1
        j = high + 1

        while True:
            # 왼쪽에서 피벗보다 큰 값 찾기
            i += 1
            while arr[i] < pivot:
                i += 1

            # 오른쪽에서 피벗보다 작은 값 찾기
            j -= 1
            while arr[j] > pivot:
                j -= 1

            # 교차하면 종료
            if i >= j:
                return j

            # 교환
            arr[i], arr[j] = arr[j], arr[i]

    def quick_sort_helper(arr, low, high):
        if low < high:
            pivot_idx = hoare_partition(arr, low, high)
            quick_sort_helper(arr, low, pivot_idx)
            quick_sort_helper(arr, pivot_idx + 1, high)

    quick_sort_helper(arr, 0, len(arr) - 1)
    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2, 7, 1, 10]
print(f"정렬 전: {numbers}")
quick_sort_hoare(numbers)
print(f"정렬 후: {numbers}")
Lomuto 판은 pivot_idx - 1과 pivot_idx + 1로 나눠 피벗 칸을 빼고 재귀하는데, 이 Hoare 판은 (low, pivot_idx)와 (pivot_idx + 1, high)로 pivot_idx를 왼쪽에 포함한다. 앞 「분할(Partition) 기법」에서 본 대로 Hoare 분할이 돌려주는 j는 피벗이 자리 잡은 칸이 아니라 두 구역의 경계라서, 그 칸도 아직 정렬이 끝나지 않았기 때문이다. 아래 자바 Hoare 판도 같다.
3-Way Partition 버전
def quick_sort_3way(arr):
    """
    3-way 퀵 정렬
    중복 값이 많을 때 효율적

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    def three_way_partition(arr, low, high):
        """
        3-way 분할
        < pivot, == pivot, > pivot으로 분할
        """
        pivot = arr[low]
        lt = low       # less than
        i = low + 1    # current
        gt = high      # greater than

        while i <= gt:
            if arr[i] < pivot:
                arr[lt], arr[i] = arr[i], arr[lt]
                lt += 1
                i += 1
            elif arr[i] > pivot:
                arr[i], arr[gt] = arr[gt], arr[i]
                gt -= 1
            else:  # arr[i] == pivot
                i += 1

        return lt, gt

    def quick_sort_helper(arr, low, high):
        if low < high:
            lt, gt = three_way_partition(arr, low, high)
            quick_sort_helper(arr, low, lt - 1)
            quick_sort_helper(arr, gt + 1, high)

    quick_sort_helper(arr, 0, len(arr) - 1)
    return arr


# 사용 예시 (중복 값 많음)
numbers = [5, 3, 8, 3, 2, 3, 1, 3, 10, 3]
print(f"정렬 전: {numbers}")
quick_sort_3way(numbers)
print(f"정렬 후: {numbers}")
Median-of-Three 버전
def quick_sort_median_of_three(arr):
    """
    퀵 정렬 (Median-of-Three)
    가장 실용적인 피벗 선택 방법

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    def median_of_three(arr, low, high):
        """첫 번째, 중간, 마지막 중 중간값 선택"""
        mid = (low + high) // 2

        # 세 값 정렬
        if arr[low] > arr[mid]:
            arr[low], arr[mid] = arr[mid], arr[low]
        if arr[low] > arr[high]:
            arr[low], arr[high] = arr[high], arr[low]
        if arr[mid] > arr[high]:
            arr[mid], arr[high] = arr[high], arr[mid]

        # 중간값을 high-1 위치로
        arr[mid], arr[high - 1] = arr[high - 1], arr[mid]
        return high - 1

    def partition(arr, low, high, pivot_idx):
        pivot = arr[pivot_idx]
        arr[pivot_idx], arr[high] = arr[high], arr[pivot_idx]

        i = low - 1
        for j in range(low, high):
            if arr[j] <= pivot:
                i += 1
                arr[i], arr[j] = arr[j], arr[i]

        arr[i + 1], arr[high] = arr[high], arr[i + 1]
        return i + 1

    def quick_sort_helper(arr, low, high):
        if low < high:
            if high - low >= 2:
                pivot_idx = median_of_three(arr, low, high)
            else:
                pivot_idx = high

            pivot_idx = partition(arr, low, high, pivot_idx)
            quick_sort_helper(arr, low, pivot_idx - 1)
            quick_sort_helper(arr, pivot_idx + 1, high)

    quick_sort_helper(arr, 0, len(arr) - 1)
    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2, 7, 1, 10, 9, 6]
print(f"정렬 전: {numbers}")
quick_sort_median_of_three(numbers)
print(f"정렬 후: {numbers}")
- 이 판의
median_of_three는 앞 「피벗 선택 전략」의 것과 거의 같지만, 마지막 줄이return high - 1이다. 앞의 것은 피벗 값(arr[high - 1])을 돌려줬고, 이 판은 분할 함수가 그 자리를 바로 쓰도록 인덱스를 돌려준다. 둘 다 틀린 것은 아니고 돌려주는 것이 다르다. partition(arr, low, high, pivot_idx)— 받은 자리의 값을 피벗으로 기억하고, 그 칸을high와 맞바꿔 피벗을 맨 끝으로 보낸다. 그 뒤는 Lomuto 분할 그대로다. Lomuto 분할은 피벗이 맨 끝에 있다고 보고 짜여 있어서 이렇게 옮긴다.if high - low >= 2:— 구간에 원소가 3개 이상일 때만 Median-of-Three를 쓴다. 첫 · 가운데 · 끝 세 칸이 서로 달라야 세 값 중 중간을 고를 수 있기 때문이다. 2개 이하면 그냥 끝 칸(high)을 피벗으로 쓴다.
반복적 구현
def quick_sort_iterative(arr):
    """
    반복적 퀵 정렬
    스택을 이용하여 재귀 제거

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    def partition(arr, low, high):
        pivot = arr[high]
        i = low - 1

        for j in range(low, high):
            if arr[j] <= pivot:
                i += 1
                arr[i], arr[j] = arr[j], arr[i]

        arr[i + 1], arr[high] = arr[high], arr[i + 1]
        return i + 1

    # 스택 초기화
    stack = [(0, len(arr) - 1)]

    while stack:
        low, high = stack.pop()

        if low < high:
            pivot_idx = partition(arr, low, high)

            # 양쪽 부분을 스택에 추가
            stack.append((low, pivot_idx - 1))
            stack.append((pivot_idx + 1, high))

    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2, 7, 1, 10]
print(f"정렬 전: {numbers}")
quick_sort_iterative(numbers)
print(f"정렬 후: {numbers}")
하이브리드 버전 (퀵 + 삽입)
def quick_sort_hybrid(arr):
    """
    하이브리드 퀵 정렬
    작은 배열은 삽입 정렬 사용

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    CUTOFF = 10  # 임계값

    def insertion_sort_range(arr, low, high):
        """범위 지정 삽입 정렬"""
        for i in range(low + 1, high + 1):
            key = arr[i]
            j = i - 1

            while j >= low and arr[j] > key:
                arr[j + 1] = arr[j]
                j -= 1

            arr[j + 1] = key

    def partition(arr, low, high):
        pivot = arr[high]
        i = low - 1

        for j in range(low, high):
            if arr[j] <= pivot:
                i += 1
                arr[i], arr[j] = arr[j], arr[i]

        arr[i + 1], arr[high] = arr[high], arr[i + 1]
        return i + 1

    def quick_sort_helper(arr, low, high):
        # 작은 배열은 삽입 정렬
        if high - low + 1 <= CUTOFF:
            insertion_sort_range(arr, low, high)
        elif low < high:
            pivot_idx = partition(arr, low, high)
            quick_sort_helper(arr, low, pivot_idx - 1)
            quick_sort_helper(arr, pivot_idx + 1, high)

    quick_sort_helper(arr, 0, len(arr) - 1)
    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2, 7, 1, 10, 9, 6]
print(f"정렬 전: {numbers}")
quick_sort_hybrid(numbers)
print(f"정렬 후: {numbers}")
insertion_sort_range가 삽입 정렬을 구간 low~high에만 하는 함수다.
for i in range(low + 1, high + 1):— 구간의 두 번째 칸부터 끝 칸까지 하나씩 본다.low~i - 1은 이미 정렬된 앞부분이다.key = arr[i]— 이번에 끼워 넣을 값을 따로 들고 있는다.while j >= low and arr[j] > key:— 정렬된 앞부분을 뒤에서부터 보며,key보다 큰 값을 한 칸씩 뒤로 민다(arr[j + 1] = arr[j]).arr[j + 1] = key— 더 밀 값이 없으면 비어 있는 그 칸에key를 넣는다.
이 예시 배열은 원소가 10개라 CUTOFF = 10 이하이므로, 실제로는 분할 없이 삽입 정렬만으로 끝난다.
랜덤 피벗 버전
import random

def quick_sort_random(arr):
    """
    랜덤 피벗 퀵 정렬
    최악의 경우를 확률적으로 회피

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    def partition_random(arr, low, high):
        # 랜덤하게 피벗 선택하여 마지막과 교환
        random_idx = random.randint(low, high)
        arr[random_idx], arr[high] = arr[high], arr[random_idx]

        pivot = arr[high]
        i = low - 1

        for j in range(low, high):
            if arr[j] <= pivot:
                i += 1
                arr[i], arr[j] = arr[j], arr[i]

        arr[i + 1], arr[high] = arr[high], arr[i + 1]
        return i + 1

    def quick_sort_helper(arr, low, high):
        if low < high:
            pivot_idx = partition_random(arr, low, high)
            quick_sort_helper(arr, low, pivot_idx - 1)
            quick_sort_helper(arr, pivot_idx + 1, high)

    quick_sort_helper(arr, 0, len(arr) - 1)
    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2, 7, 1, 10]
print(f"정렬 전: {numbers}")
quick_sort_random(numbers)
print(f"정렬 후: {numbers}")
Java 구현
기본 버전
public class QuickSort {

    /**
     * 퀵 정렬 기본 구현
     *
     * @param arr 정렬할 배열
     */
    public static void quickSort(int[] arr) {
        if (arr == null || arr.length == 0) {
            return;
        }
        quickSortHelper(arr, 0, arr.length - 1);
    }

    private static void quickSortHelper(int[] arr, int low, int high) {
        if (low < high) {
            // 분할
            int pivotIdx = partition(arr, low, high);

            // 좌우 재귀 정렬
            quickSortHelper(arr, low, pivotIdx - 1);
            quickSortHelper(arr, pivotIdx + 1, high);
        }
    }

    private static int partition(int[] arr, int low, int high) {
        int pivot = arr[high];  // 마지막 원소를 피벗으로
        int i = low - 1;        // 작은 값들의 마지막 인덱스

        for (int j = low; j < high; j++) {
            if (arr[j] <= pivot) {
                i++;
                // 교환
                int temp = arr[i];
                arr[i] = arr[j];
                arr[j] = temp;
            }
        }

        // 피벗을 올바른 위치로
        int temp = arr[i + 1];
        arr[i + 1] = arr[high];
        arr[high] = temp;

        return i + 1;
    }

    // 사용 예시
    public static void main(String[] args) {
        int[] numbers = {5, 3, 8, 4, 2, 7, 1, 10};

        System.out.print("정렬 전: ");
        printArray(numbers);

        quickSort(numbers);

        System.out.print("정렬 후: ");
        printArray(numbers);
    }

    private static void printArray(int[] arr) {
        for (int num : arr) {
            System.out.print(num + " ");
        }
        System.out.println();
    }
}
Hoare Partition 버전
public class QuickSortHoare {

    /**
     * 퀵 정렬 (Hoare Partition)
     *
     * @param arr 정렬할 배열
     */
    public static void quickSort(int[] arr) {
        if (arr == null || arr.length == 0) {
            return;
        }
        quickSortHelper(arr, 0, arr.length - 1);
    }

    private static void quickSortHelper(int[] arr, int low, int high) {
        if (low < high) {
            int pivotIdx = hoarePartition(arr, low, high);
            quickSortHelper(arr, low, pivotIdx);
            quickSortHelper(arr, pivotIdx + 1, high);
        }
    }

    private static int hoarePartition(int[] arr, int low, int high) {
        int pivot = arr[low];
        int i = low - 1;
        int j = high + 1;

        while (true) {
            // 왼쪽에서 피벗보다 큰 값 찾기
            do {
                i++;
            } while (arr[i] < pivot);

            // 오른쪽에서 피벗보다 작은 값 찾기
            do {
                j--;
            } while (arr[j] > pivot);

            // 교차하면 종료
            if (i >= j) {
                return j;
            }

            // 교환
            int temp = arr[i];
            arr[i] = arr[j];
            arr[j] = temp;
        }
    }

    // 사용 예시
    public static void main(String[] args) {
        int[] numbers = {5, 3, 8, 4, 2, 7, 1, 10};

        System.out.print("정렬 전: ");
        printArray(numbers);

        quickSort(numbers);

        System.out.print("정렬 후: ");
        printArray(numbers);
    }

    private static void printArray(int[] arr) {
        for (int num : arr) {
            System.out.print(num + " ");
        }
        System.out.println();
    }
}
3-Way Partition 버전
public class QuickSort3Way {

    /**
     * 3-way 퀵 정렬
     * 중복 값이 많을 때 효율적
     *
     * @param arr 정렬할 배열
     */
    public static void quickSort(int[] arr) {
        if (arr == null || arr.length == 0) {
            return;
        }
        quickSortHelper(arr, 0, arr.length - 1);
    }

    private static void quickSortHelper(int[] arr, int low, int high) {
        if (low < high) {
            int[] bounds = threeWayPartition(arr, low, high);
            quickSortHelper(arr, low, bounds[0] - 1);
            quickSortHelper(arr, bounds[1] + 1, high);
        }
    }

    private static int[] threeWayPartition(int[] arr, int low, int high) {
        int pivot = arr[low];
        int lt = low;       // less than
        int i = low + 1;    // current
        int gt = high;      // greater than

        while (i <= gt) {
            if (arr[i] < pivot) {
                // 교환 arr[lt] <-> arr[i]
                int temp = arr[lt];
                arr[lt] = arr[i];
                arr[i] = temp;
                lt++;
                i++;
            } else if (arr[i] > pivot) {
                // 교환 arr[i] <-> arr[gt]
                int temp = arr[i];
                arr[i] = arr[gt];
                arr[gt] = temp;
                gt--;
            } else {  // arr[i] == pivot
                i++;
            }
        }

        return new int[]{lt, gt};
    }

    // 사용 예시
    public static void main(String[] args) {
        int[] numbers = {5, 3, 8, 3, 2, 3, 1, 3, 10, 3};

        System.out.print("정렬 전: ");
        printArray(numbers);

        quickSort(numbers);

        System.out.print("정렬 후: ");
        printArray(numbers);
    }

    private static void printArray(int[] arr) {
        for (int num : arr) {
            System.out.print(num + " ");
        }
        System.out.println();
    }
}
자바 구현의 /** ... */ 주석은 Javadoc이고, @param arr 정렬할 배열은 「매개변수 arr가 무엇인지」를 적는 표시다. 실행에는 영향이 없다.
제네릭 버전
import java.util.Comparator;

public class QuickSortGeneric {

    /**
     * 제네릭 퀵 정렬
     *
     * @param arr 정렬할 배열
     * @param comparator 비교자
     */
    public static <T> void quickSort(T[] arr, Comparator<T> comparator) {
        if (arr == null || arr.length == 0) {
            return;
        }
        quickSortHelper(arr, 0, arr.length - 1, comparator);
    }

    private static <T> void quickSortHelper(T[] arr, int low, int high,
                                            Comparator<T> comparator) {
        if (low < high) {
            int pivotIdx = partition(arr, low, high, comparator);
            quickSortHelper(arr, low, pivotIdx - 1, comparator);
            quickSortHelper(arr, pivotIdx + 1, high, comparator);
        }
    }

    private static <T> int partition(T[] arr, int low, int high,
                                     Comparator<T> comparator) {
        T pivot = arr[high];
        int i = low - 1;

        for (int j = low; j < high; j++) {
            if (comparator.compare(arr[j], pivot) <= 0) {
                i++;
                // 교환
                T temp = arr[i];
                arr[i] = arr[j];
                arr[j] = temp;
            }
        }

        // 피벗을 올바른 위치로
        T temp = arr[i + 1];
        arr[i + 1] = arr[high];
        arr[high] = temp;

        return i + 1;
    }

    // 사용 예시
    public static void main(String[] args) {
        // Integer 배열 정렬
        Integer[] numbers = {5, 3, 8, 4, 2, 7, 1, 10};
        quickSort(numbers, Comparator.naturalOrder());
        System.out.print("오름차순: ");
        printArray(numbers);

        // 내림차순 정렬
        Integer[] numbers2 = {5, 3, 8, 4, 2, 7, 1, 10};
        quickSort(numbers2, Comparator.reverseOrder());
        System.out.print("내림차순: ");
        printArray(numbers2);

        // String 배열 길이로 정렬
        String[] words = {"apple", "pie", "banana", "cat"};
        quickSort(words, Comparator.comparingInt(String::length));
        System.out.print("길이 순: ");
        printArray(words);
    }

    private static <T> void printArray(T[] arr) {
        for (T item : arr) {
            System.out.print(item + " ");
        }
        System.out.println();
    }
}
public static <T> void quickSort(T[] arr, Comparator<T> comparator)— 반환 타입 앞의<T>는 이 메서드가 제네릭 메서드라는 표시다. 호출할 때T자리에Integer나String이 채워진다. 정렬 기준은 Comparator로 받는다.comparator.compare(arr[j], pivot) <= 0—compare(a, b)는 a가 앞이면 음수, 같으면 0, b가 앞이면 양수를 돌려준다. 그래서<= 0은 int 판의arr[j] <= pivot과 같은 뜻이다.Integer[] numbers— 제네릭의T자리에는int같은 기본형이 못 들어가서int[]대신 래퍼 클래스 배열Integer[]를 쓴다.Comparator.naturalOrder()— 그 타입이 원래 가진 순서(Comparable의compareTo)로 비교하는 Comparator를 돌려준다. 숫자면 오름차순이다.Comparator.reverseOrder()는 그 반대 순서다.Comparator.comparingInt(String::length)—String::length는 메서드 참조로,s -> s.length()와 같다. 「각 문자열의 길이(int)를 꺼내 그 값으로 비교하라」는 Comparator를 만든다.
참고 자료:
- “Introduction to Algorithms” (CLRS) - Thomas H. Cormen
- “Algorithms” (4th Edition) - Robert Sedgewick
- Wikipedia: Quicksort
- GeeksforGeeks: Quick Sort
자신만의 철학을 만들어가는 중입니다.


댓글남기기