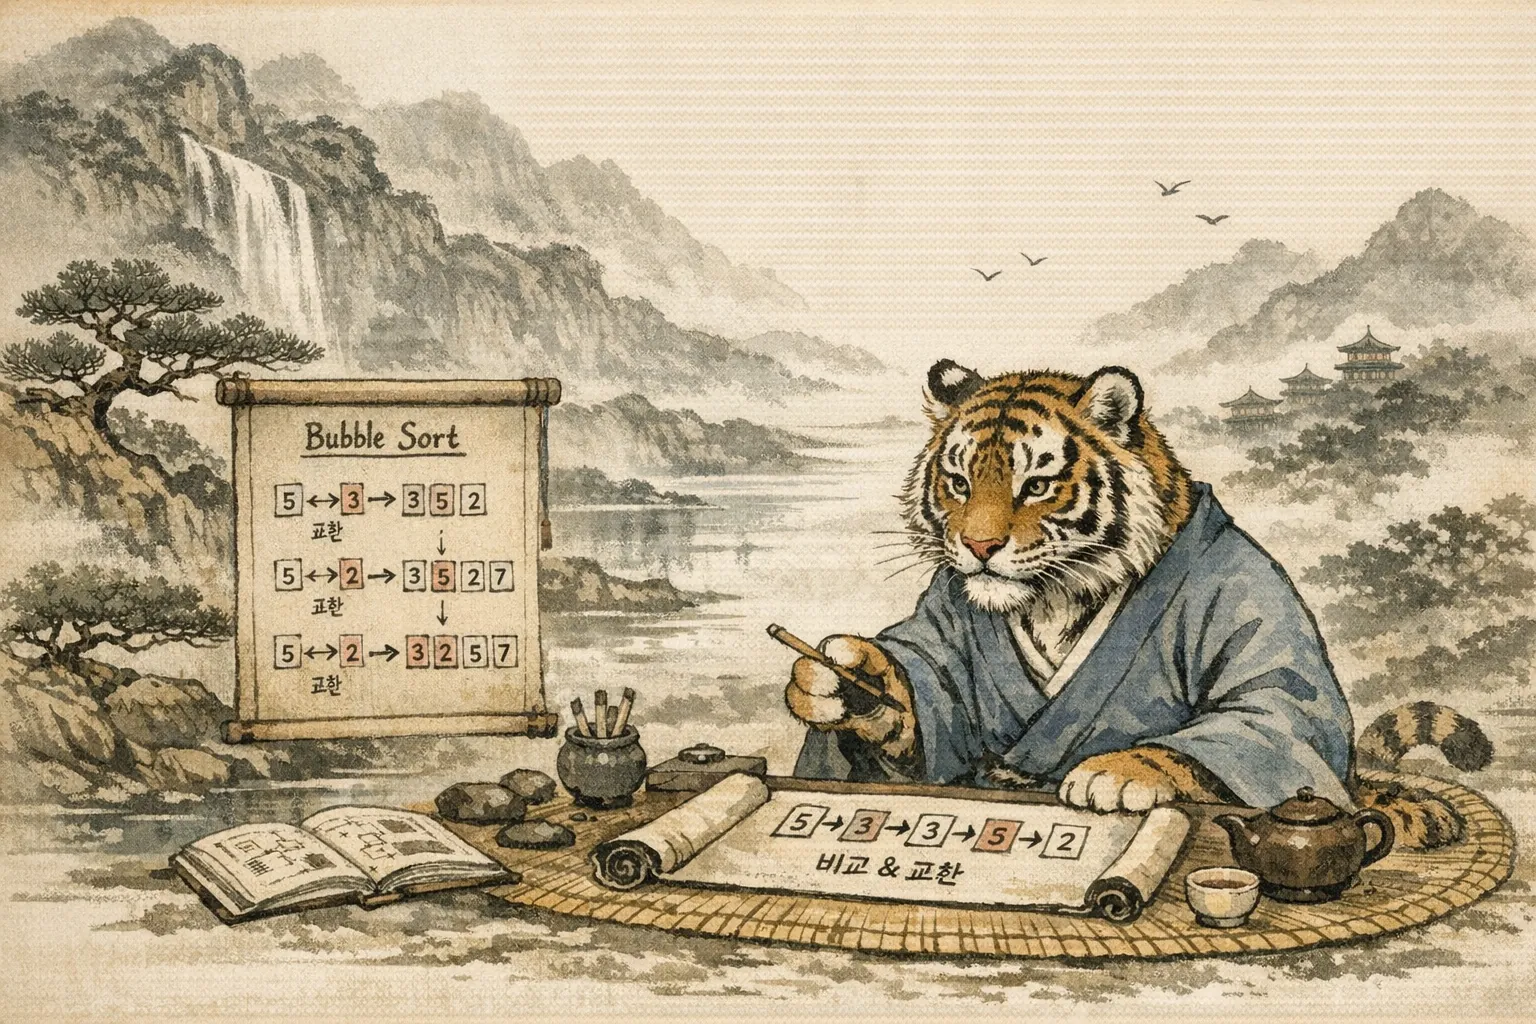
버블 정렬(Bubble Sort)은 가장 기본적인 정렬 알고리즘 중 하나다. 이름처럼 큰 값이 물속의 거품처럼 배열의 끝으로 올라가는(이동하는) 모습에서 이름이 붙었다. 코딩 테스트나 면접에서 자주 등장하는 기본 알고리즘이라, 원리와 구현을 확실히 이해해 두는 것이 좋다.
이 글은 원리 → 애니메이션 → 코드(파이썬 · 자바) → 복잡도 → 장단점 → 최적화 순서로 간다. 코드를 먼저 보여 주는 까닭은, 뒤에 나오는 복잡도와 최적화 이야기가 전부 그 코드의 반복문을 세는 이야기이기 때문이다.
버블 정렬이란?
버블 정렬은 인접한 두 원소를 비교하여 정렬하는 알고리즘이다. 배열을 앞에서부터 훑으면서 인접한 두 원소의 크기를 비교하고, 정렬 순서가 잘못되어 있으면(앞이 더 크면) 두 원소의 위치를 바꾼다.
동작 원리
- 배열의 첫 번째 원소부터 시작하여 인접한 원소와 비교한다
- 순서가 잘못되어 있으면 두 원소의 위치를 바꾼다
- 배열의 끝까지 이 과정을 반복하면 가장 큰 원소가 맨 뒤로 이동한다
- 아직 정렬되지 않은 앞부분에 대해 1~3 과정을 반복한다
배열을 처음부터 끝까지 한 번 훑는 것을 이 글에서는 1회 순회(또는 1회차)라고 부른다.
인터랙티브 애니메이션
위에서 설명한 버블 정렬 과정을 직접 눈으로 확인해 볼 수 있다. 시작 버튼을 눌러 정렬 과정을 단계별로 관찰한다.
- 회색: 정렬되지 않은 기본 상태
- 주황색: 현재 비교 중인 두 요소
- 빨간색: 교환이 발생하는 요소 (위치 이동 애니메이션)
- 초록색: 정렬이 완료된 요소
- 속도를 조절하여 천천히 또는 빠르게 볼 수 있다
- 두 요소가 실제로 위치를 바꾸는 애니메이션을 볼 수 있다
코드 구현
같은 알고리즘을 파이썬과 자바로 한 번씩 보여 준다. 코딩 테스트에서 파이썬을 많이 쓰기 때문에 파이썬 코드를 먼저 두고, 자바 코드는 그 아래에 같은 모양으로 둔다. 자바만 아는 사람은 자바 코드와 나란히 놓고 읽으면 된다.
파이썬을 처음 보는 사람을 위한 안내
이 글의 파이썬 코드를 읽는 데 필요한 문법만 자바와 비교해 둔다.
def bubble_sort(arr):— 함수(자바의 메서드) 선언이다. 반환형과 매개변수 타입을 적지 않는다. 줄 끝의:는 「여기서부터 몸통이 시작된다」는 표시다- 들여쓰기가 중괄호
{ }역할을 한다.for나if줄 아래에서 한 칸 더 들여 쓴 줄들이 그 반복문 · 조건문의 몸통이고, 들여쓰기가 원래대로 돌아오면 몸통이 끝난 것이다 """…"""— 함수 설명 글인 독스트링이다. 자바의/** ... */(Javadoc) 자리이고 실행에는 영향이 없다#— 한 줄 주석이다. 자바의//와 같다numbers = [5, 3, 8, 4, 2]— 리스트를 만들어 변수numbers에 담는다. 변수 앞에int[]같은 타입을 적지 않는다. 파이썬 리스트는 자바의ArrayList처럼 길이가 바뀔 수 있는 목록이지만, 값을 꺼낼 때는 자바 배열처럼arr[j]라고 쓴다(get(j)가 아니다). 이 글에서는 자바 배열과 같은 것으로 읽어도 된다len(arr)— 리스트의 길이다. 자바 배열의arr.length,ArrayList의size()와 같다range는for문이 돌 숫자를 만든다. 끝 숫자는 포함하지 않는다range(5)→ 0, 1, 2, 3, 4. 자바의for (int i = 0; i < 5; i++)range(2, 5)→ 2, 3, 4. 자바의for (int i = 2; i < 5; i++)range(4, 0, -1)→ 4, 3, 2, 1. 세 번째 숫자는 증가폭이고,-1이면 거꾸로 센다
not swapped— 자바의!swapped다.True·False는 자바의true·false다a, b = b, a— 두 변수의 값을 맞바꾼다. 오른쪽 값 둘을 먼저 묶은 다음 왼쪽 변수 둘에 한 번에 나눠 담아서, 자바처럼 임시 변수(temp)가 필요 없다print(f"정렬 전: {numbers}")— f-string이다. 중괄호 자리에numbers의 값이 끼워져 출력된다
Python 구현
기본 버전
def bubble_sort(arr):
    """
    버블 정렬 기본 구현

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    n = len(arr)

    # 전체 순회 (n-1번)
    for i in range(n - 1):
        # 인접한 원소 비교 (정렬된 부분 제외)
        for j in range(n - 1 - i):
            # 앞의 원소가 더 크면 교환
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]

    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2]
print(f"정렬 전: {numbers}")
bubble_sort(numbers)
print(f"정렬 후: {numbers}")
한 줄씩 따라가기.
n = len(arr)— 원소 개수를n에 담는다. 예시에서는 5다for i in range(n - 1):— 바깥 반복은 회차를 센다.i는 0부터n - 2까지, 모두n - 1번 돈다. 한 회차가 끝날 때마다 가장 큰 값 하나가 맨 뒤로 가므로,n - 1개를 뒤로 보내면 남은 하나는 저절로 맨 앞에 맞는 자리에 있다for j in range(n - 1 - i):— 안쪽 반복은 한 회차 안에서arr[j]와arr[j + 1]을 비교한다. 이미 맨 뒤에 확정된i개는 다시 볼 필요가 없어서- i만큼 덜 돈다if arr[j] > arr[j + 1]:— 앞이 더 크면 순서가 틀린 것이다arr[j], arr[j + 1] = arr[j + 1], arr[j]— 두 값을 맞바꾼다bubble_sort(numbers)— 반환값을 받지 않았는데도 다음 줄에서numbers가 정렬돼 있다. 함수 안의arr가 바깥의numbers와 같은 리스트를 가리켜서, 함수가 그 리스트를 직접 바꾸기 때문이다. 자바에서 배열을 메서드에 넘기면 메서드가 바꾼 내용이 바깥 배열에도 보이는 것과 같다. 마지막 줄return arr는 원하면sorted_list = bubble_sort(numbers)처럼 받아서 쓸 수도 있게 돌려줄 뿐이다
실행하면 이렇게 나온다(직접 돌려 확인했다).
정렬 전: [5, 3, 8, 4, 2]
정렬 후: [2, 3, 4, 5, 8]
최적화 버전 (조기 종료)
기본 버전은 배열이 중간에 이미 다 정렬돼도 남은 회차를 끝까지 돈다. 그래서 swapped라는 플래그 변수를 하나 둔다. 한 회차를 도는 동안 한 번이라도 자리를 바꿨으면 True가 된다. 한 회차를 다 돌았는데 False 그대로라면 바꿀 곳이 하나도 없었다는 뜻, 즉 이미 정렬이 끝났다는 뜻이므로 거기서 멈춘다.
def bubble_sort_optimized(arr):
    """
    최적화된 버블 정렬 구현
    이미 정렬된 경우 조기 종료

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    n = len(arr)

    for i in range(n - 1):
        swapped = False  # 교환 발생 여부 플래그

        for j in range(n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True

        # 한 번의 순회에서 교환이 없었다면 이미 정렬됨
        if not swapped:
            break

    return arr


# 사용 예시
numbers = [1, 2, 3, 4, 5]  # 이미 정렬된 배열
print(f"정렬 전: {numbers}")
bubble_sort_optimized(numbers)  # 1번의 순회만 수행
print(f"정렬 후: {numbers}")
한 줄씩 따라가기. 기본 버전과 다른 줄만 본다.
swapped = False— 회차를 시작할 때마다 깃발을 내린다swapped = True— 자리를 한 번이라도 바꾸면 깃발을 올린다if not swapped: break— 회차가 끝났는데 깃발이 내려가 있으면 바깥 반복을 빠져나간다
예시처럼 이미 정렬된 [1, 2, 3, 4, 5]를 넣으면 첫 회차에서 4번 비교하는 동안 한 번도 바꾸지 않으므로, 첫 회차만 돌고 끝난다.
Java 구현
기본 버전
public class BubbleSort {

    /**
     * 버블 정렬 기본 구현
     *
     * @param arr 정렬할 배열
     */
    public static void bubbleSort(int[] arr) {
        int n = arr.length;

        // 전체 순회 (n-1번)
        for (int i = 0; i < n - 1; i++) {
            // 인접한 원소 비교 (정렬된 부분 제외)
            for (int j = 0; j < n - 1 - i; j++) {
                // 앞의 원소가 더 크면 교환
                if (arr[j] > arr[j + 1]) {
                    // swap
                    int temp = arr[j];
                    arr[j] = arr[j + 1];
                    arr[j + 1] = temp;
                }
            }
        }
    }

    /**
     * 배열 출력
     */
    public static void printArray(int[] arr) {
        for (int num : arr) {
            System.out.print(num + " ");
        }
        System.out.println();
    }

    public static void main(String[] args) {
        int[] numbers = {5, 3, 8, 4, 2};

        System.out.print("정렬 전: ");
        printArray(numbers);

        bubbleSort(numbers);

        System.out.print("정렬 후: ");
        printArray(numbers);
    }
}
반복문 구조는 파이썬 기본 버전과 줄마다 같다. 다른 곳은 두 군데다.
- 자리 바꾸기 — 자바는
a, b = b, a문법이 없어서temp에arr[j]를 잠깐 담아 두고,arr[j]에arr[j + 1]을 덮어쓴 뒤,arr[j + 1]에temp를 넣는다 /** ... */와@param— Javadoc 주석이다.@param arr 정렬할 배열은 「매개변수arr는 정렬할 배열이다」라는 설명이고, 실행에는 영향이 없다
최적화 버전
기본 버전과 같은 printArray를 이 클래스에도 넣었다. printArray는 기본 버전의 BubbleSort 클래스 안에 있는 메서드라서, 이 클래스에서 그냥 부르면 찾지 못한다. (처음 쓴 코드는 이걸 빠뜨렸다. 자바 컴파일러 javac로 컴파일해 보니 「그런 이름을 찾을 수 없다」는 cannot find symbol 오류가 나서 고쳤다.)
public class BubbleSortOptimized {

    /**
     * 최적화된 버블 정렬 구현
     *
     * @param arr 정렬할 배열
     */
    public static void bubbleSortOptimized(int[] arr) {
        int n = arr.length;

        for (int i = 0; i < n - 1; i++) {
            boolean swapped = false;  // 교환 발생 여부 플래그

            for (int j = 0; j < n - 1 - i; j++) {
                if (arr[j] > arr[j + 1]) {
                    // swap
                    int temp = arr[j];
                    arr[j] = arr[j + 1];
                    arr[j + 1] = temp;
                    swapped = true;
                }
            }

            // 교환이 없었다면 이미 정렬됨
            if (!swapped) {
                break;
            }
        }
    }

    /**
     * 배열 출력
     */
    public static void printArray(int[] arr) {
        for (int num : arr) {
            System.out.print(num + " ");
        }
        System.out.println();
    }

    public static void main(String[] args) {
        int[] numbers = {1, 2, 3, 4, 5};  // 이미 정렬된 배열

        System.out.print("정렬 전: ");
        printArray(numbers);

        bubbleSortOptimized(numbers);  // 1번의 순회만 수행

        System.out.print("정렬 후: ");
        printArray(numbers);
    }
}
swapped를 내리고 · 올리고 · 확인하는 세 곳이 파이썬 최적화 버전과 같은 자리에 있다.
복잡도 분석
시간 복잡도
시간 복잡도는 입력 크기가 늘어날 때 연산을 몇 번쯤 하는지를 나타낸 것이고, 빅오 표기(Big-O)로 적는다. O(n)은 입력이 늘어난 만큼 시간도 늘어난다는 뜻이고, O(n²)은 입력이 늘어난 만큼의 제곱으로 시간이 늘어난다는 뜻이다.
| 경우 | 복잡도 | 설명 |
|---|---|---|
| 최선 (Best) | O(n) | 이미 정렬된 경우 (조기 종료를 넣은 최적화 버전) |
| 평균 (Average) | O(n²) | 일반적인 경우 |
| 최악 (Worst) | O(n²) | 역순으로 정렬된 경우 |
최선의 O(n)은 앞의 최적화 버전에만 해당한다. 이미 정렬된 배열이면 첫 회차에서 n-1번 비교하고 swapped가 False라 멈추기 때문이다. 기본 버전은 정렬돼 있어도 모든 회차를 돌아서 최선도 O(n²)이다.
평균이 O(n²)인 까닭은 교환 횟수로 볼 수 있다. 값이 아무렇게나 섞여 있으면 두 값을 골랐을 때 순서가 틀려 있을 확률이 반이라, 바꿔야 할 일도 최악(n(n-1)/2번)의 절반인 n(n-1)/4번쯤 된다. n이 5 · 6 · 7일 때 가능한 모든 순서를 넣어 교환 횟수의 평균을 내 보니 정확히 n(n-1)/4(5, 7.5, 10.5)가 나왔다. 절반이어도 n²에 비례해 늘어나므로 O(n²)이다.
최악이 역순인 까닭은, 역순이면 어느 두 값을 비교해도 앞이 더 크기 때문이다. 그래서 비교할 때마다 자리를 바꿔야 하고, 조기 종료도 마지막 회차까지 한 번도 일어나지 않는다.
계산 과정
- 비교 횟수: (n-1) + (n-2) + … + 2 + 1 = n(n-1)/2
- 교환 횟수: 최악의 경우 비교 횟수와 동일
- 따라서 시간 복잡도는 O(n²)
비교 횟수가 왜 이 식이 되는지. 1회차 순회에서는 배열 끝까지 인접한 두 값을 비교하므로 (n-1)번 비교한다. 1회차가 끝나면 가장 큰 값이 맨 뒤로 확정되므로, 2회차는 그 자리를 뺀 (n-2)번만 비교하면 된다. 이렇게 회차마다 이미 정렬이 끝난 뒷자리 하나씩을 빼고 비교하다 보면, 마지막 회차는 단 1번만 비교하고 끝난다. 그래서 전체 비교 횟수는 (n-1)부터 1까지 더한 것과 같다.
그 합이 왜 n(n-1)/2인지. 같은 합을 한 번은 큰 수부터, 한 번은 작은 수부터 적어 위아래로 더해 본다.
  (n-1) + (n-2) + ... +   2   +   1
+   1   +   2   + ... + (n-2) + (n-1)
---------------------------------------
    n   +   n   + ... +   n   +   n      ← n이 (n-1)개
위아래 짝은 모두 합이 n이고 짝은 (n-1)개라서, 두 줄을 더한 값은 n(n-1)이다. 원래 합은 그 절반이므로 n(n-1)/2다. n이 5면 5×4/2 = 10번이다.
교환 횟수가 최악에서 비교 횟수와 같은 까닭은 바로 위에 적었다 — 역순이면 비교할 때마다 교환하기 때문이다. n이 5인 역순 배열 [5, 4, 3, 2, 1]로 세어 보면 비교 10번, 교환 10번이다(직접 돌려 셌다).
n(n-1)/2를 왜 O(n²)이라고 부르는지. 식을 풀면 n²/2 - n/2다. 빅오는 「n이 커질 때 얼마나 빨리 커지는가」만 보므로 두 가지를 버린다.
- /2 같은 곱해진 상수 — n이 2배가 되면 n²/2도 n²도 똑같이 4배가 된다. 늘어나는 비율이 같으니 빅오에서는 같은 것으로 본다
- - n/2 같은 더 느리게 크는 항 — n이 1,000이면 n²/2는 50만이고 n/2는 500이다. n이 클수록 n²에 비해 거의 보이지 않게 된다
남는 것이 n²이라 O(n²)이다.
공간 복잡도
- O(1): 제자리 정렬(in-place sorting)
- 추가 메모리를 거의 사용하지 않음 (교환용 임시 변수만 필요)
장단점
장점
- 구현이 간단하다: 코드가 직관적이고 이해하기 쉽다
- 추가 메모리가 거의 필요 없다: 공간 복잡도 O(1)
- 안정 정렬(Stable Sort): 같은 값의 순서가 유지된다. 앞이 더 클 때만(
>) 바꾸고 같을 때는 바꾸지 않아서다 - 교육용으로 적합: 정렬 알고리즘의 기본 개념 학습에 좋다
단점
- 느린 속도: 시간 복잡도 O(n²)로 대용량 데이터에 부적합하다
- 비효율적: 다른 O(n²) 알고리즘인 삽입 정렬, 선택 정렬보다도 느리다. 선택 정렬과 견주면 이유 하나는 셀 수 있다 — 비교 횟수는 둘 다 n(n-1)/2로 같지만, 선택 정렬은 자리 바꾸기를 전체에서 최대 n-1번 하고 버블 정렬은 최악에 비교 횟수만큼(n(n-1)/2번) 한다. 삽입 정렬보다 느린 이유는 이 글에서 따져 보지 않았고, 실제 실행 시간도 재 보지 않았다
- 실무에서 사용하지 않음: 더 빠른 알고리즘(퀵 정렬, 병합 정렬, 힙 정렬 등)을 쓴다
최적화 기법
1. 조기 종료 (Early Exit)
「코드 구현」의 최적화 버전에서 본 swapped 플래그를 이용한 방법이다. 한 번의 순회에서 교환이 전혀 발생하지 않으면 이미 정렬이 완료된 것이므로 알고리즘을 종료한다.
# 이미 정렬된 배열: [1, 2, 3, 4, 5]
# 최적화 없이: n(n-1)/2 = 10번 비교 (O(n²))
# 최적화 후: n-1 = 4번 비교 후 종료 (O(n))
원래 이 주석은 「최적화 없이 25번 비교」라고 적혀 있었다. 25는 n²(5×5)을 그대로 쓴 값이고, 앞의 계산 과정대로라면 n이 5일 때 비교는 10번이다. 두 버전을 직접 돌려 비교 횟수를 세어 보니 10번과 4번이 나와서 고쳤다.
2. 양방향 버블 정렬 (Cocktail Shaker Sort)
한 방향으로만 순회하지 않고 양방향으로 번갈아 가며 정렬한다. 왼쪽에서 오른쪽으로 갈 때는 기본 버전처럼 가장 큰 값이 맨 오른쪽으로 가고, 오른쪽에서 왼쪽으로 돌아올 때는 거꾸로 가장 작은 값이 맨 왼쪽으로 간다. 기본 버전에서는 맨 뒤에 있는 작은 값이 한 회차에 한 칸씩만 앞으로 오는데, 돌아오는 순회가 있으면 그 값이 한 번에 맨 앞까지 온다. 그래도 최악의 경우는 여전히 O(n²)이다. 기본 버전보다 실제로 얼마나 빠른지는 이 글에서 재 보지 않았다.
def cocktail_sort(arr):
    """
    칵테일 쉐이커 정렬 (양방향 버블 정렬)
    """
    n = len(arr)
    start = 0
    end = n - 1
    swapped = True

    while swapped:
        swapped = False

        # 왼쪽에서 오른쪽으로
        for i in range(start, end):
            if arr[i] > arr[i + 1]:
                arr[i], arr[i + 1] = arr[i + 1], arr[i]
                swapped = True

        if not swapped:
            break

        swapped = False
        end -= 1

        # 오른쪽에서 왼쪽으로
        for i in range(end - 1, start - 1, -1):
            if arr[i] > arr[i + 1]:
                arr[i], arr[i + 1] = arr[i + 1], arr[i]
                swapped = True

        start += 1

    return arr
한 줄씩 따라가기.
start,end— 아직 정렬이 안 끝난 구간의 왼쪽 끝과 오른쪽 끝 위치다. 처음엔 배열 전체(0부터 n-1까지)다while swapped:— 직전 순회에서 한 번이라도 바꿨으면 계속 돈다. 처음엔 한 번은 돌아야 하니True로 시작한다for i in range(start, end):—i가start부터end - 1까지 1씩 커지며arr[i]와arr[i + 1]을 비교한다(end는 포함하지 않으므로, 마지막 비교는arr[end - 1]과arr[end]다). 이 순회가 끝나면 구간에서 가장 큰 값이end자리에 온다if not swapped: break— 한 번도 안 바꿨으면 정렬이 끝난 것이라 멈춘다end -= 1— 가장 큰 값이end자리에 확정됐으니 오른쪽 끝을 한 칸 줄인다. 자바의end--와 같다for i in range(end - 1, start - 1, -1):— 증가폭이-1이라 거꾸로 센다.end - 1에서 시작해 1씩 줄어들며start - 1바로 앞, 즉start까지 돈다. 그래서 오른쪽에서 왼쪽으로 인접한 값을 비교하고, 끝나면 구간에서 가장 작은 값이start자리에 온다start += 1— 가장 작은 값이start자리에 확정됐으니 왼쪽 끝을 한 칸 줄인다. 자바의start++와 같다
[5, 3, 8, 4, 2, 1, 9]를 넣어 돌려 보니 [1, 2, 3, 4, 5, 8, 9]가 나왔다.
언제 사용해야 할까?
아래 기준 가운데 「10개 이하」 · 「100개 이상」이라는 숫자는 원래 글에 있던 것인데, 어디서 나온 기준인지는 확인하지 않았다. 「데이터가 적으면 n²도 작다」는 뜻의 대략적인 눈금으로 읽는다.
적합한 경우
- 데이터가 매우 작을 때 (10개 이하)
- 거의 정렬된 데이터 — 조기 종료 덕분이다. 몇 회차만 돌면 바꿀 곳이 없어져 거기서 멈춘다
- 알고리즘 학습 목적
- 코드 단순성이 중요한 경우
부적합한 경우
- 대용량 데이터 (100개 이상)
- 성능이 중요한 경우
- 실무 프로젝트
다른 정렬 알고리즘과 비교
표의 O(n log n)은 O(n²)보다 훨씬 천천히 커지는 시간이다. n이 1,024일 때 n²은 약 100만, n log n은 약 1만이다. 공간 칸의 O(log n)과 O(n)은 정렬하는 동안 따로 쓰는 메모리가 입력에 따라 그만큼 늘어난다는 뜻이다.
| 알고리즘 | 최선 | 평균 | 최악 | 공간 | 안정성 |
|---|---|---|---|---|---|
| 버블 정렬 | O(n) | O(n²) | O(n²) | O(1) | 안정 |
| 선택 정렬 | O(n²) | O(n²) | O(n²) | O(1) | 불안정 |
| 삽입 정렬 | O(n) | O(n²) | O(n²) | O(1) | 안정 |
| 퀵 정렬 | O(n log n) | O(n log n) | O(n²) | O(log n) | 불안정 |
| 병합 정렬 | O(n log n) | O(n log n) | O(n log n) | O(n) | 안정 |
| 힙 정렬 | O(n log n) | O(n log n) | O(n log n) | O(1) | 불안정 |
실전 문제 연습
버블 정렬은 코딩 테스트에서 직접 구현을 요구하기보다는, 원리를 이해하고 있는지 확인하는 문제가 많다.
예제 문제
- 정렬 과정 출력하기: 버블 정렬의 각 단계를 출력하는 프로그램 작성
- K번째 순회 결과: K번 순회 후 배열의 상태 출력. 아래 코드의 회차별 출력에서 K번째 줄이 답이다
- 최소 교환 횟수: 배열을 정렬하기 위해 필요한 최소 교환 횟수 계산. 이웃한 두 값만 바꿀 수 있을 때는 버블 정렬이 실제로 자리를 바꾼 횟수가 곧 답이다. 배열 안에서 「앞이 더 큰 두 값」의 쌍(순서가 틀린 쌍)을 세어 보면 이유가 보인다. 이웃한 두 값을 한 번 바꾸면 그 두 값끼리의 순서만 바뀌고 나머지 값들과의 앞뒤는 그대로라서, 순서가 틀린 쌍은 한 번에 많아야 하나 줄어든다. 그러니 어떤 방법을 써도 순서가 틀린 쌍의 개수보다 적게 바꿀 수는 없다. 버블 정렬은 순서가 틀린 이웃만 바꾸므로 바꿀 때마다 정확히 하나씩 줄이고, 그래서 그 개수만큼만 바꾸고 끝난다. 직접 돌려서도 확인했다 — 원소가 1개부터 6개까지인 배열의 가능한 모든 순서(6개면 720가지)마다, 이웃 교환을 한 번 · 두 번 · 세 번 해서 나올 수 있는 배열을 모두 따라가며 정렬된 배열에 처음 닿는 횟수를 구했고, 그 값이 버블 정렬의 교환 횟수와 전부 같았다. 아래 예시
[5, 3, 8, 4, 2]는 7번이다. 이웃하지 않은 두 값도 바꿀 수 있는 문제라면 답이 달라지고, 그 풀이는 이 글에서 다루지 않는다
def bubble_sort_with_steps(arr):
    """정렬 과정을 출력하는 버블 정렬"""
    n = len(arr)
    print(f"초기 상태: {arr}")

    for i in range(n - 1):
        swapped = False
        for j in range(n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True

        if swapped:
            print(f"{i + 1}회차 순회: {arr}")
        else:
            print(f"{i + 1}회차 순회: 변화 없음 (정렬 완료)")
            break

    return arr

# 실행
numbers = [5, 3, 8, 4, 2]
bubble_sort_with_steps(numbers)
최적화 버전과 반복 구조가 같고, 회차가 끝날 때마다 배열을 출력하는 줄만 더했다. {i + 1}은 i가 0부터 세므로 사람이 읽기 좋게 1부터 회차 번호를 붙이려는 것이다. 실행하면 이렇게 나온다(직접 돌려 확인했다).
초기 상태: [5, 3, 8, 4, 2]
1회차 순회: [3, 5, 4, 2, 8]
2회차 순회: [3, 4, 2, 5, 8]
3회차 순회: [3, 2, 4, 5, 8]
4회차 순회: [2, 3, 4, 5, 8]
회차마다 맨 뒤에 큰 값이 하나씩 확정되는 것이 보인다 — 1회차에 8, 2회차에 5, 3회차에 4다. 이 배열은 마지막 4회차에도 3과 2를 바꿨기 때문에 「변화 없음」 줄 없이 끝난다.
마무리
버블 정렬은 가장 기본적인 정렬 알고리즘으로, 실무에서는 거의 사용되지 않지만 알고리즘 학습의 시작점으로서 중요한 의미를 가진다.
핵심 요약
- 인접한 원소를 비교하며 정렬하는 단순한 알고리즘
- 시간 복잡도는 O(n²), 공간 복잡도는 O(1)
- 안정 정렬이며 제자리 정렬
- 조기 종료 최적화로 최선의 경우 O(n) 가능
- 실무보다는 교육 목적에 적합
버블 정렬을 이해했다면, 다음 단계로 선택 정렬(Selection Sort)이나 삽입 정렬(Insertion Sort) 같은 다른 O(n²) 정렬 알고리즘을 학습하거나, 더 효율적인 퀵 정렬(Quick Sort)이나 병합 정렬(Merge Sort) 같은 O(n log n) 알고리즘으로 나아가는 것을 추천한다.
참고 자료
- 위키백과 - 버블 정렬
- VisuAlgo - 정렬 시각화
- Introduction to Algorithms (CLRS) — 알고리즘 교과서다. CLRS는 저자 네 명(Cormen, Leiserson, Rivest, Stein)의 성 첫 글자를 딴 별명이다
자신만의 철학을 만들어가는 중입니다.



댓글남기기