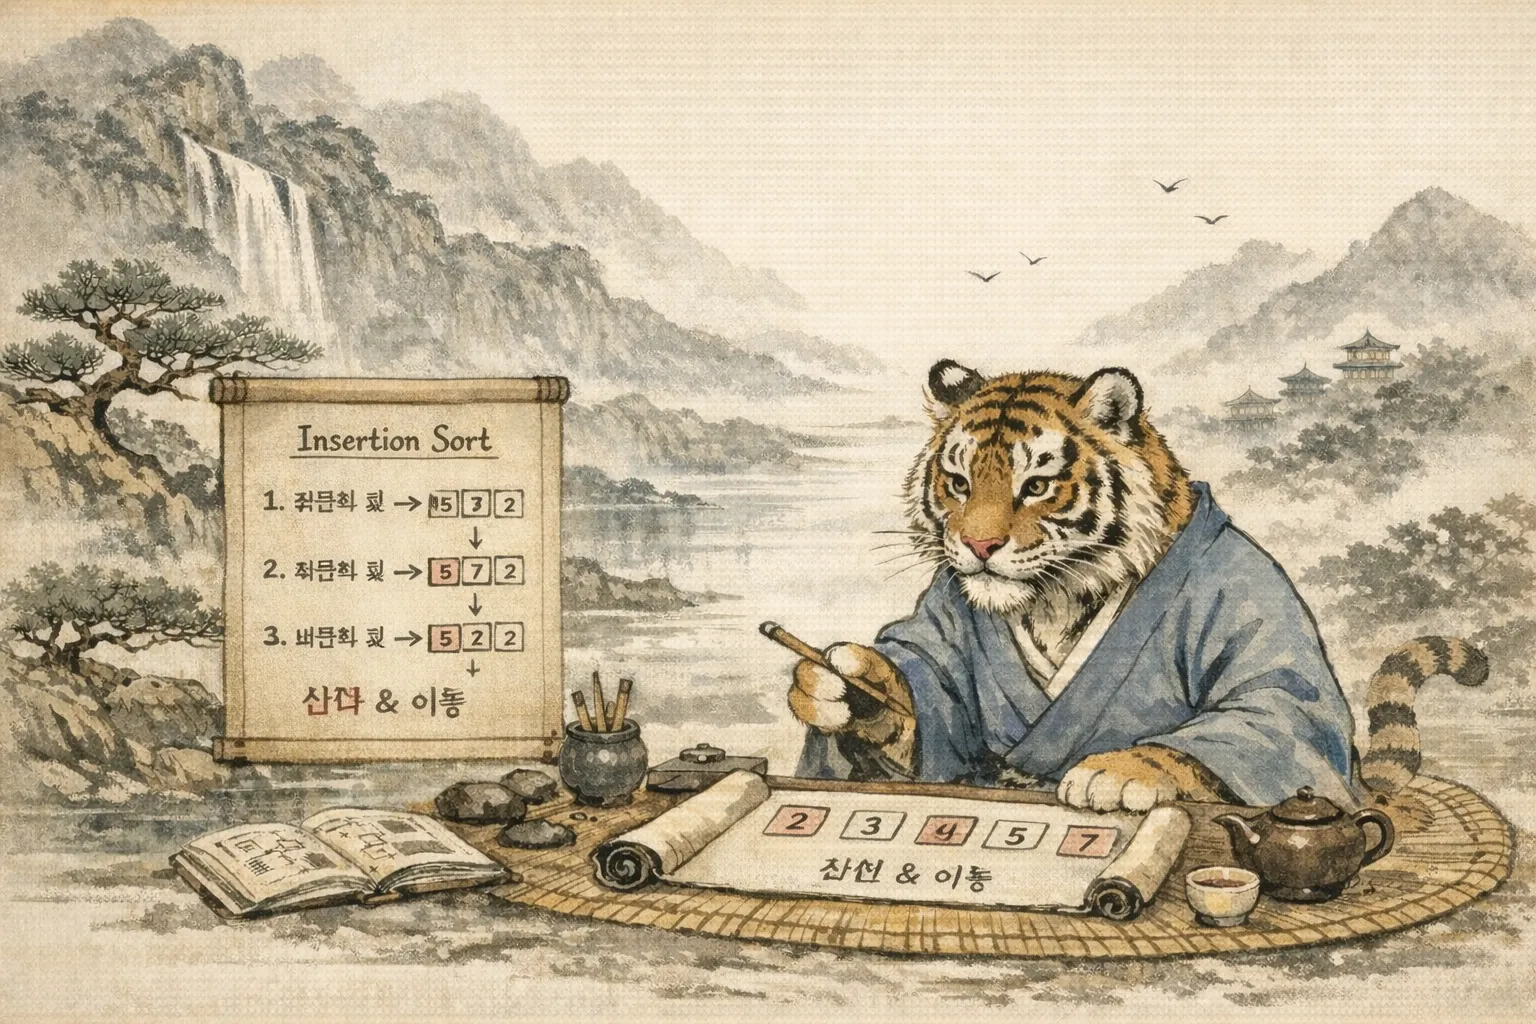
삽입 정렬(Insertion Sort)은 정렬된 부분에 새로운 원소를 적절한 위치에 삽입하는 방식의 정렬 알고리즘이다. 카드 게임에서 손에 든 카드를 정렬하는 방식과 비슷해서 직관적으로 이해하기 쉽고, 부분적으로 정렬된 데이터에서 빠르다.
삽입 정렬이란?
삽입 정렬은 배열을 정렬된 부분과 정렬되지 않은 부분으로 나누고, 정렬되지 않은 부분의 원소를 정렬된 부분의 적절한 위치에 삽입하는 알고리즘이다. 카드를 한 장씩 받아서 이미 손에 든 카드 사이의 알맞은 자리에 꽂는 것과 같다.
동작 원리
- 배열의 두 번째 원소부터 시작 (첫 번째 원소는 이미 정렬된 것으로 간주)
- 현재 원소를 선택하여 정렬된 부분의 적절한 위치를 찾음
- 적절한 위치를 찾기 위해 정렬된 부분을 역순으로 탐색
- 현재 원소보다 큰 값들은 오른쪽으로 한 칸씩 이동
- 적절한 위치에 현재 원소를 삽입
- 모든 원소에 대해 2~5 과정 반복
4번의 「이동」은 두 원소를 맞바꾸는(교환) 것이 아니다. 큰 값을 오른쪽 칸에 덮어 써서 한 칸 밀기만 하고, 현재 원소는 따로 꺼내 두었다가 5번에서 빈 자리에 한 번 넣는다. 이 차이는 뒤의 비교 표에서 다시 나온다.
인터랙티브 애니메이션
위에서 설명한 삽입 정렬 과정을 직접 눈으로 확인할 수 있다. 시작 버튼을 눌러 정렬 과정을 단계별로 관찰한다.
- 회색: 정렬되지 않은 기본 상태
- 주황색: 현재 삽입할 요소 (key)
- 노란색: 정렬된 부분에서 비교 중인 요소
- 빨간색: 오른쪽으로 이동하는 요소
- 초록색: 정렬이 완료된 요소
- 속도를 조절하여 천천히 또는 빠르게 확인할 수 있다.
- 요소가 정렬된 부분에 삽입되는 과정을 볼 수 있다.
코드 구현
글의 뒷부분(복잡도 · 실무 활용 · 최적화)이 모두 이 기본 구현을 바탕으로 하므로 코드를 먼저 본다. 자바 버전은 이 섹션 뒤쪽 「Java 구현」에 있다.
Python 코드를 읽기 위한 최소한
이 글의 예제는 대부분 Python이다. 자바만 아는 독자가 걸리는 문법을 여기 한 번에 모아 둔다. 뒤의 코드에서 막히면 이 목록으로 돌아온다.
def 이름(매개변수):— 메서드(함수) 정의다. 반환 타입과 매개변수 타입을 적지 않는다. 코드 블록은 중괄호 대신 들여쓰기로 가른다"""..."""— 함수 맨 위에 둔 세 따옴표 문자열은 그 함수의 설명(독스트링)이다. 실행에는 영향이 없어서 자바의/** ... */주석처럼 읽으면 된다. 그 안의Args:(매개변수) ·Returns:(반환값)는 흔히 쓰는 적는 형식일 뿐 문법이 아니다#— 한 줄 주석이다. 자바의//에 해당한다def f(arr, threshold=10):—=10은 기본값이다. 호출할 때threshold를 안 넘기면 10이 들어간다None— 자바의null이다True/False— 자바의true/false다elif— 자바의else if다and/or/not— 자바의&&/||/!다.not head는 「head가None이다」를 뜻한다while current:·while prev.next and ...— 조건 자리에 객체를 그대로 두면 「None이 아니다」로 읽힌다.while current:는 자바의while (current != null)이다print(값)— 화면에 찍고 줄을 바꾼다. 자바의System.out.println(값)이다len(arr)— 리스트 길이다. 자바의arr.length다range(a, b)— a부터 b 바로 앞까지의 정수다.for i in range(1, n):은 자바의for (int i = 1; i < n; i++)이다.range(a, b, -1)처럼 세 번째 값을 주면 그만큼씩 움직인다 —range(i, left, -1)은 i부터 1씩 줄여left바로 앞(left+1)까지다a // b— 나눗셈 후 소수점을 버린 몫이다. 자바의 정수 나눗셈a / b에 해당한다. 자바와 달리 주석이 아니다.gap //= 2는gap = gap // 2다left, right = 0, i - 1— 변수 두 개에 한 번에 값을 넣는다.left = 0; right = i - 1;과 같다return a, b— 값 두 개를 묶어 한 번에 돌려준다. 받는 쪽은x, y = f()로 나눠 받는다. 이렇게 괄호로 묶인 값 묶음(1, 5)를 튜플이라고 부르고, 자바의 「값 두 개짜리 작은 객체」라고 생각하면 된다lst.append(v)— 리스트 맨 뒤에 붙인다. 자바List.add(v)다.lst.copy()는 리스트를 통째로 복사한 새 리스트다f"결과: {arr}"— 문자열 안{}자리에 변수 값을 끼워 넣는다. 자바의"결과: " + arr이다x if 조건 else y— 조건이 참이면 x, 아니면 y다. 자바의 삼항 연산자조건 ? x : y다lambda x: x[1]— 이름 없는 함수다. 자바 람다x -> x[1]이다. Python에서는 함수도 값처럼 변수에 담거나 인자로 넘길 수 있다(key=len은 길이를 구하는 함수len자체를 넘긴다)f(words, key=len)—이름=값꼴로 어느 매개변수에 넣을지 이름을 붙여 넘긴다class ListNode:안의def __init__(self, ...)— 자바의 생성자다.self는 자바의this이고, Python은 이것을 첫 번째 매개변수로 직접 적는다
Python 구현
기본 버전
def insertion_sort(arr):
    """
    삽입 정렬 기본 구현

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 정렬된 리스트
    """
    n = len(arr)

    # 두 번째 원소부터 시작
    for i in range(1, n):
        key = arr[i]  # 현재 삽입할 원소
        j = i - 1     # 정렬된 부분의 마지막 인덱스

        # key보다 큰 원소들을 오른쪽으로 이동
        while j >= 0 and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1

        # 적절한 위치에 key 삽입
        arr[j + 1] = key

    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2]
print(f"정렬 전: {numbers}")
insertion_sort(numbers)
print(f"정렬 후: {numbers}")
한 줄씩 따라가기. for i in range(1, n):은 인덱스 1부터 끝까지 돈다 — 인덱스 0 하나짜리 앞부분은 이미 정렬된 것으로 본다. key = arr[i]로 이번에 끼워 넣을 값을 따로 꺼내 둔다. j는 정렬된 부분의 맨 끝에서 출발해 왼쪽으로 간다. while j >= 0 and arr[j] > key:는 「아직 배열 앞을 넘지 않았고, 왼쪽 값이 key보다 크면」 그 값을 한 칸 오른쪽(arr[j + 1])으로 밀고 j를 하나 줄인다. 멈추는 순간 arr[j]는 key 이하이거나 j가 -1이므로, 그 바로 오른쪽 arr[j + 1]이 key의 자리다. 실행하면 정렬 전: [5, 3, 8, 4, 2], 정렬 후: [2, 3, 4, 5, 8]이 찍힌다. 함수가 넘겨받은 리스트 자체를 고치므로 반환값을 받지 않아도 numbers가 바뀌어 있다.
내림차순 버전
def insertion_sort_descending(arr):
    """
    삽입 정렬 내림차순 구현

    Args:
        arr (list): 정렬할 리스트

    Returns:
        list: 내림차순으로 정렬된 리스트
    """
    n = len(arr)

    for i in range(1, n):
        key = arr[i]
        j = i - 1

        # key보다 작은 원소들을 오른쪽으로 이동
        while j >= 0 and arr[j] < key:
            arr[j + 1] = arr[j]
            j -= 1

        arr[j + 1] = key

    return arr


# 사용 예시
numbers = [5, 3, 8, 4, 2]
print(f"정렬 전: {numbers}")
insertion_sort_descending(numbers)
print(f"정렬 후 (내림차순): {numbers}")
기본 버전과 다른 곳은 while의 비교 arr[j] < key 하나다. 이번에는 key보다 작은 값을 오른쪽으로 밀어서 큰 값이 앞에 남는다. 결과는 [8, 5, 4, 3, 2]다.
범위 지정 삽입 정렬
def insertion_sort_range(arr, start, end):
    """
    배열의 특정 범위만 삽입 정렬
    하이브리드 정렬 알고리즘에서 사용

    Args:
        arr (list): 정렬할 리스트
        start (int): 시작 인덱스
        end (int): 끝 인덱스 (포함)

    Returns:
        list: 정렬된 리스트
    """
    for i in range(start + 1, end + 1):
        key = arr[i]
        j = i - 1

        while j >= start and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1

        arr[j + 1] = key

    return arr


# 사용 예시
numbers = [9, 5, 3, 8, 4, 2, 1]
print(f"정렬 전: {numbers}")
insertion_sort_range(numbers, 1, 5)  # 인덱스 1~5만 정렬
print(f"부분 정렬 후: {numbers}")
기본 버전에서 「0부터 끝까지」를 「start부터 end까지」로 바꾼 것이다. range(start + 1, end + 1)은 end를 포함하려고 끝에 1을 더했고, while은 j >= 0 대신 j >= start에서 멈춰 범위 밖 왼쪽을 건드리지 않는다. 결과는 [9, 2, 3, 4, 5, 8, 1]이다 — 맨 앞 9와 맨 뒤 1은 범위 밖이라 그대로다. 이 함수는 뒤의 「하이브리드 정렬 알고리즘」 예제에서 다시 쓴다.
비교 함수를 넘기는 버전
def insertion_sort_generic(arr, key=None, reverse=False):
    """
    제네릭 삽입 정렬 구현

    Args:
        arr (list): 정렬할 리스트
        key (function): 비교 기준 함수
        reverse (bool): True면 내림차순, False면 오름차순

    Returns:
        list: 정렬된 리스트
    """
    n = len(arr)

    for i in range(1, n):
        current = arr[i]
        current_key = key(current) if key else current
        j = i - 1

        while j >= 0:
            compare_key = key(arr[j]) if key else arr[j]

            # reverse에 따라 비교 방향 결정
            if reverse:
                if compare_key >= current_key:
                    break
            else:
                if compare_key <= current_key:
                    break

            arr[j + 1] = arr[j]
            j -= 1

        arr[j + 1] = current

    return arr


# 사용 예시
# 1. 문자열 길이로 정렬
words = ["apple", "pie", "banana", "cat"]
insertion_sort_generic(words, key=len)
print(f"길이 순 정렬: {words}")

# 2. 튜플의 두 번째 요소로 정렬
data = [(1, 5), (3, 2), (2, 8), (4, 1)]
insertion_sort_generic(data, key=lambda x: x[1])
print(f"두 번째 요소 순 정렬: {data}")

# 3. 절댓값으로 정렬
numbers = [-5, 3, -8, 4, -2]
insertion_sort_generic(numbers, key=abs)
print(f"절댓값 순 정렬: {numbers}")

# 4. 내림차순 정렬
numbers2 = [5, 3, 8, 4, 2]
insertion_sort_generic(numbers2, reverse=True)
print(f"내림차순 정렬: {numbers2}")
원래 제목은 「제네릭 버전」이었는데, 자바의 제네릭(<T>)과는 다른 것이라 이름을 바꿨다. 여기서 하는 일은 「무엇을 기준으로 비교할지」를 함수로 받는 것이다. key는 원소 하나를 받아 비교에 쓸 값을 돌려주는 함수다. current_key = key(current) if key else current는 「key 함수를 받았으면 그 함수에 원소를 넣은 결과로, 안 받았으면(None) 원소 그대로」 비교한다는 뜻이다. while 안에서는 오름차순이면 왼쪽 값이 현재 값 이하일 때, 내림차순(reverse=True)이면 왼쪽 값이 현재 값 이상일 때 멈춘다. 같을 때도 멈추므로 같은 값끼리 순서가 바뀌지 않는다.
실행 결과는 이렇다.
길이 순 정렬: ['pie', 'cat', 'apple', 'banana']— 길이 3인pie와cat은 원래 순서 그대로 남는다두 번째 요소 순 정렬: [(4, 1), (3, 2), (1, 5), (2, 8)]절댓값 순 정렬: [-2, 3, 4, -5, -8]내림차순 정렬: [8, 5, 4, 3, 2]
고친 것: 이 글의 처음 코드는
reverse=True일 때compare_key < current_key에서 멈췄고, 실제로 돌려 보니 4번 예시가[2, 3, 4, 5, 8](오름차순)로 나왔다. 멈추는 조건을compare_key >= current_key로 고쳐[8, 5, 4, 3, 2]가 나오는 것을 확인했다(2026-10-19).
Java 구현
기본 버전
public class InsertionSort {

    /**
     * 삽입 정렬 기본 구현
     *
     * @param arr 정렬할 배열
     */
    public static void insertionSort(int[] arr) {
        int n = arr.length;

        // 두 번째 원소부터 시작
        for (int i = 1; i < n; i++) {
            int key = arr[i];  // 현재 삽입할 원소
            int j = i - 1;     // 정렬된 부분의 마지막 인덱스

            // key보다 큰 원소들을 오른쪽으로 이동
            while (j >= 0 && arr[j] > key) {
                arr[j + 1] = arr[j];
                j--;
            }

            // 적절한 위치에 key 삽입
            arr[j + 1] = key;
        }
    }

    /**
     * 배열 출력
     */
    public static void printArray(int[] arr) {
        for (int num : arr) {
            System.out.print(num + " ");
        }
        System.out.println();
    }

    public static void main(String[] args) {
        int[] numbers = {5, 3, 8, 4, 2};

        System.out.print("정렬 전: ");
        printArray(numbers);

        insertionSort(numbers);

        System.out.print("정렬 후: ");
        printArray(numbers);
    }
}
Python 기본 버전을 그대로 옮긴 것이다. 실행하면 정렬 전: 5 3 8 4 2, 정렬 후: 2 3 4 5 8이 찍힌다.
제네릭 버전
import java.util.Comparator;

public class InsertionSortGeneric {

    /**
     * 제네릭 삽입 정렬 구현
     *
     * @param arr 정렬할 배열
     * @param comparator 비교자 (null이면 자연 순서)
     */
    public static <T extends Comparable<T>> void insertionSort(
            T[] arr, Comparator<T> comparator) {
        int n = arr.length;

        for (int i = 1; i < n; i++) {
            T key = arr[i];
            int j = i - 1;

            // key보다 큰 원소들을 오른쪽으로 이동
            while (j >= 0) {
                int cmp = (comparator != null)
                    ? comparator.compare(arr[j], key)
                    : arr[j].compareTo(key);

                if (cmp <= 0) break;

                arr[j + 1] = arr[j];
                j--;
            }

            arr[j + 1] = key;
        }
    }

    /**
     * 자연 순서로 정렬 (오름차순)
     */
    public static <T extends Comparable<T>> void insertionSort(T[] arr) {
        insertionSort(arr, null);
    }

    /**
     * 배열의 특정 범위만 정렬
     */
    public static <T extends Comparable<T>> void insertionSortRange(
            T[] arr, int start, int end, Comparator<T> comparator) {
        for (int i = start + 1; i <= end; i++) {
            T key = arr[i];
            int j = i - 1;

            while (j >= start) {
                int cmp = (comparator != null)
                    ? comparator.compare(arr[j], key)
                    : arr[j].compareTo(key);

                if (cmp <= 0) break;

                arr[j + 1] = arr[j];
                j--;
            }

            arr[j + 1] = key;
        }
    }

    public static void main(String[] args) {
        // Integer 배열 정렬
        Integer[] numbers = {5, 3, 8, 4, 2};
        System.out.print("정렬 전: ");
        printArray(numbers);

        insertionSort(numbers);

        System.out.print("정렬 후: ");
        printArray(numbers);

        // 내림차순 정렬
        Integer[] numbers2 = {5, 3, 8, 4, 2};
        insertionSort(numbers2, Comparator.reverseOrder());

        System.out.print("내림차순: ");
        printArray(numbers2);

        // 문자열 길이로 정렬
        String[] words = {"apple", "pie", "banana", "cat"};
        insertionSort(words, Comparator.comparingInt(String::length));

        System.out.print("길이 순: ");
        printArray(words);
    }

    private static <T> void printArray(T[] arr) {
        for (T item : arr) {
            System.out.print(item + " ");
        }
        System.out.println();
    }
}
한 줄씩 따라가기. 메서드 이름 앞의 <T extends Comparable<T>>는 「이 메서드는 타입 T를 빈칸으로 두고 쓰는데, T에는 Comparable을 구현한 타입만 들어올 수 있다」는 선언이다. Comparable을 구현한 타입은 compareTo()로 자기들끼리 비교할 수 있으므로, 비교 규칙을 따로 안 넘겨도 정렬이 된다. Comparator는 두 객체 중 무엇을 앞에 둘지 정하는 규칙을 담은 인터페이스다. compare(a, b)가 음수면 a가 앞, 양수면 b가 앞, 0이면 순서가 같다는 뜻이다.
int cmp = (comparator != null) ? ... : ...;는 삼항 연산자다. comparator를 받았으면 그것으로 비교하고, 안 넘겼으면(null) 그 타입이 원래 가진 compareTo()(자연 순서)를 대신 쓴다 — Integer는 숫자 크기, String은 사전 순서가 자연 순서다. cmp <= 0이면 왼쪽 값이 key 이하라는 뜻이니 멈추고, 아니면 한 칸 민다. 기본 버전의 arr[j] > key를 비교 결과로 바꿔 쓴 것뿐이다.
insertionSort라는 이름의 메서드가 두 개 있다. 인자 개수가 달라서(배열 하나 / 배열과 Comparator) 자바가 호출할 때 넘긴 인자를 보고 어느 쪽인지 고른다. 이것을 오버로딩이라고 한다. 인자가 배열 하나인 쪽은 insertionSort(arr, null)로 두 인자짜리를 부르면서 Comparator 자리에 null을 넣어, 「자연 순서로 정렬해라」를 뜻하게 한다. insertionSortRange는 앞의 Python 「범위 지정 삽입 정렬」을 자바로 옮겨 둔 것이고, 이 main에서는 부르지 않는다.
main에서 int[]가 아니라 Integer[]를 쓰는 이유는, 제네릭의 빈칸 T에는 int 같은 기본형이 들어갈 수 없고 객체 타입만 들어가기 때문이다. 그래서 int를 감싼 래퍼 클래스 Integer의 배열을 넘긴다. Comparator.reverseOrder()는 자연 순서를 거꾸로 뒤집는 Comparator를 만들어 주고, Comparator.comparingInt(String::length)는 문자열의 길이를 기준으로 비교하는 Comparator를 만들어 준다 — String::length는 메서드 참조 문법으로 “이 문자열의 길이를 구하는 메서드를 그대로 써라”는 뜻이다. 실행하면 정렬 후: 2 3 4 5 8, 내림차순: 8 5 4 3 2, 길이 순: pie cat apple banana가 찍힌다.
정렬 과정 시각화 버전
public class InsertionSortVisualized {

    /**
     * 삽입 정렬 과정을 시각화하여 출력
     *
     * @param arr 정렬할 배열
     */
    public static void insertionSortWithVisualization(int[] arr) {
        int n = arr.length;

        System.out.println("초기 상태:");
        printArrayWithHighlight(arr, -1, -1);
        System.out.println();

        for (int i = 1; i < n; i++) {
            System.out.println("--- " + i + "회차 ---");
            int key = arr[i];
            int j = i - 1;

            System.out.println("삽입할 key: " + key);

            int moves = 0;
            while (j >= 0 && arr[j] > key) {
                arr[j + 1] = arr[j];
                j--;
                moves++;
            }

            arr[j + 1] = key;

            if (moves > 0) {
                System.out.println(moves + "번 이동하여 인덱스 " + (j + 1) + "에 삽입");
            } else {
                System.out.println("이동 없음 (이미 정렬된 위치)");
            }

            printArrayWithHighlight(arr, i, -1);
            System.out.println();
        }

        System.out.println("정렬 완료!");
        printArrayWithHighlight(arr, n - 1, -1);
    }

    /**
     * 배열을 출력하며 특정 위치를 강조
     */
    private static void printArrayWithHighlight(int[] arr, int sortedUntil, int current) {
        for (int i = 0; i < arr.length; i++) {
            if (i <= sortedUntil) {
                System.out.print("[" + arr[i] + "]");  // 정렬된 부분
            } else if (i == current) {
                System.out.print("(" + arr[i] + ")");  // 현재 삽입 중
            } else {
                System.out.print(" " + arr[i] + " ");   // 정렬 안 된 부분
            }
            System.out.print(" ");
        }
        System.out.println();
    }

    public static void main(String[] args) {
        int[] numbers = {5, 3, 8, 4, 2};
        insertionSortWithVisualization(numbers);
    }
}
기본 버전에 출력만 더한 것이다. moves는 이번 회차에 오른쪽으로 민 횟수를 센다. printArrayWithHighlight(arr, sortedUntil, current)는 인덱스 sortedUntil까지를 [ ]로 감싸 「정렬된 부분」으로 보여 준다. 처음에 -1을 넘기는 것은 「아직 정렬된 칸이 없다」는 뜻이다(0번 인덱스도 -1보다 크므로 [ ]가 안 붙는다). 세 번째 인자 current는 이 코드에서 늘 -1이라 ( )로 감싸는 「현재 삽입 중」 분기는 한 번도 실행되지 않는다. 쓰이지 않는 자리가 남아 있는 것이다. 실행하면 처음 두 회차는 이렇게 찍힌다.
초기 상태:
 5   3   8   4   2

--- 1회차 ---
삽입할 key: 3
1번 이동하여 인덱스 0에 삽입
[3] [5]  8   4   2

--- 2회차 ---
삽입할 key: 8
이동 없음 (이미 정렬된 위치)
[3] [5] [8]  4   2
복잡도 분석
시간 복잡도
시간 복잡도는 입력 크기가 늘어날 때 연산을 몇 번쯤 하는지를 나타낸 것이고, 빅오 표기(Big-O)로 적는다. O(n)은 입력이 늘어난 만큼 시간도 늘어난다는 뜻이고, O(n²)은 입력이 늘어난 만큼의 제곱으로 시간이 늘어난다는 뜻이다.
| 경우 | 복잡도 | 설명 |
|---|---|---|
| 최선 (Best) | O(n) | 이미 정렬된 경우 |
| 평균 (Average) | O(n²) | 일반적인 경우 |
| 최악 (Worst) | O(n²) | 역순으로 정렬된 경우 |
계산 과정
- 비교 횟수: 최악(역순)이면 i번째
key가 정렬된 부분 i개를 전부 지나야 하므로 1 + 2 + … + (n-1) = n(n-1)/2. 이 합은 맨 앞과 맨 뒤를 짝지으면 나온다 — 1과 (n-1), 2와 (n-2)처럼 짝마다 합이 n이고, 항이 n-1개이니 짝은 (n-1)/2개라 n × (n-1)/2다 - 이동 횟수: 최악에서는 비교할 때마다 한 칸씩 밀기 때문에 비교 횟수와 같은 n(n-1)/2다. 앞에서 말했듯 맞바꾸기가 아니라 한 칸 밀기다
- 최선의 경우: 이미 정렬되어 있으면 매
key마다 왼쪽 값과 한 번만 비교하고 멈추므로 n-1번의 비교만 수행 → O(n) - 평균의 경우: 무작위 데이터라면
key는 정렬된 부분의 대략 절반만 지나서 자리를 찾는다. 그러면 비교와 이동이 최악의 절반쯤인 n(n-1)/4 ≈ n²/4가 된다. 앞의 숫자가 1/4로 줄어도 n²에 비례해 커지는 것은 그대로라 평균 시간 복잡도도 O(n²)다
이동 횟수는 사실 그 배열의 역순 쌍 개수와 정확히 같다. 한 번 밀 때마다 「앞에 있는데 더 큰 값」 하나를 key 뒤로 넘기기 때문이다. 이때 순서가 바뀌는 것은 key와 그 큰 값 두 원소뿐이고, 다른 원소끼리의 앞뒤는 그대로다. 그래서 한 번 밀 때마다 역순 쌍이 정확히 하나 줄고 새로 생기는 쌍은 없다. 정렬이 끝나면 역순 쌍이 0개이므로, 처음 있던 역순 쌍 개수만큼 밀었다는 뜻이 된다. 그래서 역순 쌍이 적은, 거의 정렬된 데이터에서 삽입 정렬은 빠르다.
공간 복잡도
- O(1): 제자리 정렬(in-place sorting)
- 추가 메모리를 거의 사용하지 않음 (
key,i,j같은 임시 변수만 필요)
O(1)은 「추가 메모리가 입력 크기와 상관없이 일정하다」는 양의 표현이고, 제자리 정렬은 「배열 안에서 자리만 바꿔 정렬한다」는 방식의 이름이다. 삽입 정렬은 둘 다 해당한다.
장단점
장점
- 구현이 간단하다: 코드가 직관적이고 이해하기 쉬움
- 안정 정렬(Stable Sort): 같은 값의 순서가 유지됨
- 추가 메모리가 거의 필요 없다: 공간 복잡도 O(1)
- 거의 정렬된 데이터에 효율적: 최선의 경우 O(n)
- 작은 데이터셋에 효율적: 오버헤드가 적음 — 재귀 호출이나 보조 배열(정렬 중에 값을 잠시 옮겨 담으려고 따로 만드는 배열) 같은 준비 작업 없이 반복문 두 개로 끝난다
- 온라인 알고리즘: 데이터를 받는 동시에 정렬 가능 (아래 「온라인 정렬」에 예제가 있다)
단점
- 평균적으로 느림: 시간 복잡도 O(n²)로 대용량 데이터에 부적합
- 역순 정렬 시 비효율적: 최악의 경우 O(n²)
- 선택 정렬보다 데이터 이동이 많음: 선택 정렬은 맞바꾸기가 최대 n-1번이지만 삽입 정렬은 평균 n²/4번 민다
다른 O(n²) 정렬과의 비교
삽입 정렬은 버블 정렬, 선택 정렬과 함께 O(n²) 정렬 알고리즘이지만 중요한 차이가 있다.
| 특성 | 삽입 정렬 | 선택 정렬 | 버블 정렬 |
|---|---|---|---|
| 정렬 방식 | 적절한 위치에 삽입 | 최소값 선택 후 교환 | 인접 원소 교환 |
| 비교 횟수 | 평균 n²/4 | 항상 n²/2 | 평균 n²/2 |
| 교환(이동) 횟수 | 평균 n²/4 (한 칸 밀기) | 최대 n-1 | 평균 n²/4 (맞바꾸기) |
| 안정성 | 안정 정렬 | 불안정 정렬 | 안정 정렬 |
| 최선의 경우 | O(n) | O(n²) | O(n) (최적화 시) |
| 적응성 | 높음 (거의 정렬된 데이터에 강함) | 없음 | 중간 |
표를 읽는 데 필요한 것을 덧붙인다.
- n²/4와 n²/2 — 「계산 과정」에서 본 대로 n(n-1)/2 ≈ n²/2가 최악이고, 평균은 그 절반인 n²/4다. 선택 정렬은 데이터 모양과 상관없이 매번 남은 부분을 끝까지 훑으므로 항상 n²/2를 비교한다. 버블 정렬도 한 바퀴마다 남은 부분의 이웃한 쌍을 전부 비교하는데, 아래 「최적화」로 일찍 멈추지 않는 한 바퀴를 거의 n번 돌아야 해서 평균도 n²/2에 가깝다
- 버블 정렬의 교환 횟수 — 버블 정렬도 맞바꿀 때마다 역순 쌍이 하나 줄어서 교환 횟수가 역순 쌍 개수와 같다. 그래서 평균 n²/4로 삽입 정렬의 이동 횟수와 같다. 다만 맞바꾸기는 값 세 번 옮기기(임시 변수 → 왼쪽 → 오른쪽)이고 한 칸 밀기는 한 번이라, 같은 횟수라도 삽입 정렬이 덜 일한다
- 선택 정렬이 불안정한 이유 —
[5a, 5b, 2]에서 최솟값 2를 맨 앞5a와 맞바꾸면[2, 5b, 5a]가 된다. 멀리 떨어진 두 칸을 맞바꾸면서 같은 값5a가5b를 건너뛰어 순서가 뒤집힌다 - 버블 정렬의 「최적화 시」 — 한 바퀴를 도는 동안 맞바꾸기가 한 번도 없었으면 이미 정렬된 것이니 거기서 멈추는 최적화다. 이걸 넣으면 정렬된 입력에서 한 바퀴(n-1번 비교)로 끝난다
- 적응성 — 적응형 정렬(adaptive)인 정도다. 입력이 이미 정렬돼 있을수록 일이 줄어드는 성질이다. 버블 정렬이 「중간」인 것은, 맞바꾸기가 없는 바퀴가 나와야만 멈출 수 있어서다. 큰 값은 한 바퀴에 맨 뒤까지 가지만 작은 값은 한 바퀴에 한 칸씩만 앞으로 온다. 그래서
[2, 3, 4, 5, 1]처럼 맨 뒤의 작은 값 하나만 어긋나도 바퀴를 거의 n번 돈다. 삽입 정렬은 같은 입력을1하나를 네 칸 미는 것으로 끝낸다
언제 삽입 정렬이 최고일까?
- 데이터가 거의 정렬되어 있을 때
- 작은 데이터셋 (10~50개 — 흔히 드는 기준이고, 이 글에서 직접 재 보지는 않았다)
- 온라인으로 데이터를 받으면서 정렬해야 할 때
- 안정 정렬이 필요할 때
실무에서의 활용
삽입 정렬은 다음과 같은 경우에 실제로 쓰인다.
1. 하이브리드 정렬 알고리즘
많은 고급 정렬 알고리즘이 배열을 잘게 나누다가 작은 부분 배열이 되면 삽입 정렬로 마무리한다. 아래는 퀵 정렬에 그 방식을 붙인 예다. 퀵 정렬은 기준값(피벗) 하나를 골라 작은 값은 왼쪽, 큰 값은 오른쪽으로 나누고 양쪽을 같은 방식으로 다시 정렬하는 정렬이다. 나눌 때마다 피벗은 자기 최종 자리에 놓이므로, 끝까지 나누면 전체가 정렬된다.
def hybrid_quick_sort(arr, low, high, threshold=10):
    """
    퀵 정렬과 삽입 정렬의 하이브리드
    작은 부분 배열에 삽입 정렬 사용
    """
    if high - low + 1 <= threshold:
        # 작은 배열은 삽입 정렬 사용
        insertion_sort_range(arr, low, high)
    elif low < high:
        # 큰 배열은 퀵 정렬 사용
        pivot_idx = partition(arr, low, high)
        hybrid_quick_sort(arr, low, pivot_idx - 1, threshold)
        hybrid_quick_sort(arr, pivot_idx + 1, high, threshold)
한 줄씩 따라가기. 이 함수는 배열 전체가 아니라 인덱스 low부터 high까지의 구간을 정렬한다. 배열 자체가 작아지는 것이 아니라 정렬할 구간이 좁아지는 것이다. high - low + 1이 그 구간의 원소 개수이고, 이것이 threshold 이하면 앞의 「범위 지정 삽입 정렬」에서 본 insertion_sort_range로 그 구간을 끝낸다. 그보다 크면 퀵 정렬로 나눈다. partition(arr, low, high)는 이 코드 안에는 정의돼 있지 않은 함수인데, 퀵 정렬에서 구간을 피벗 기준으로 양쪽으로 나누고 그 피벗이 놓인 위치(pivot_idx)를 돌려주는 함수라고 생각하면 된다. 그 위치를 기준으로 왼쪽과 오른쪽 구간을 각각 다시 hybrid_quick_sort에 넘겨 재귀로 반복한다.
실제 사용 예시:
- Java의
Arrays.sort()(자바에 기본으로 들어 있는 라이브러리의, 배열을 정렬해 주는 메서드):int[]같은 기본형 배열에 쓰는 DualPivotQuicksort(기준값을 하나가 아니라 두 개 쓰는 퀵 정렬의 한 종류)에서 작은 배열에 삽입 정렬 사용 - Python의 Timsort: 병합 정렬(머지 정렬) 기반이지만, 데이터 안에서 이미 정렬된 구간(런, run)이 너무 짧으면 런 뒤의 원소를 몇 개 더 가져와 삽입 정렬로 그 런 안에 하나씩 끼워 넣어, 정해 둔 최소 길이까지 늘린다
2. 온라인 정렬
데이터가 하나씩 계속 들어오는 상황에서 쓸모가 있다. 새 값이 올 때마다 전체를 다시 정렬하지 않고, 이미 정렬된 목록의 알맞은 자리에 하나만 끼워 넣는다.
def online_insertion_sort(sorted_list, new_value):
    """
    이미 정렬된 리스트에 새로운 값을 삽입
    """
    # 적절한 위치 찾기
    i = len(sorted_list) - 1
    sorted_list.append(new_value)

    while i >= 0 and sorted_list[i] > new_value:
        sorted_list[i + 1] = sorted_list[i]
        i -= 1

    sorted_list[i + 1] = new_value
    return sorted_list

# 사용 예시: 점수가 들어올 때마다 오름차순 목록에 끼워 넣기
scores = [60, 70, 85, 100]
new_score = 75
online_insertion_sort(scores, new_score)
print(scores)  # [60, 70, 75, 85, 100]
한 줄씩 따라가기. i는 기존 리스트의 마지막 인덱스다. sorted_list.append(new_value)로 먼저 맨 뒤에 한 칸을 붙이는 이유는 리스트 길이를 하나 늘려 두기 위해서다 — 그래야 아래에서 값을 오른쪽으로 밀 때 sorted_list[i + 1] 자리가 존재한다. 그다음은 기본 버전의 while과 똑같이 new_value보다 큰 값을 한 칸씩 오른쪽으로 밀고, 멈춘 자리 바로 오른쪽에 new_value를 넣는다. 예시에서는 100과 85를 한 칸씩 민 뒤 70 앞에서 멈춰 [60, 70, 75, 85, 100]이 된다. 기존 리스트가 오름차순으로 정렬돼 있다는 것이 이 함수의 전제다.
고친 것: 처음 예시는
rankings = [100, 85, 70, 60](내림차순)에 75를 넣고 결과를[100, 85, 75, 70, 60]이라고 적었다. 함수는 오름차순을 전제하므로 실제로 돌려 보면60 > 75가 거짓이라 바로 멈추고[100, 85, 70, 60, 75]가 나온다. 예시를 오름차순 목록으로 바꿨다(2026-10-19).
3. 부분 정렬된 데이터
로그 파일, 센서 데이터처럼 대부분 정렬되어 있지만 일부만 섞인 데이터에 효율적이다. 이런 데이터는 기록된 시각 순서대로 쌓이는데, 여러 곳에서 동시에 기록하거나 늦게 도착한 기록이 끼면 몇 줄만 순서가 어긋난다. 역순 쌍이 적으니 앞에서 본 대로 이동이 적다.
최적화 기법
1. 이진 삽입 정렬 (Binary Insertion Sort)
삽입 위치를 찾을 때 한 칸씩 왼쪽으로 가며 비교하지 않고 이진 탐색을 써서 비교 횟수를 줄인다.
def binary_insertion_sort(arr):
    """
    이진 탐색을 이용한 삽입 정렬
    비교 횟수는 줄지만 이동 횟수는 동일
    """
    for i in range(1, len(arr)):
        key = arr[i]

        # 이진 탐색으로 삽입 위치 찾기
        left, right = 0, i - 1
        while left <= right:
            mid = (left + right) // 2
            if arr[mid] > key:
                right = mid - 1
            else:
                left = mid + 1

        # 삽입 위치는 left
        # left부터 i-1까지 오른쪽으로 이동
        for j in range(i, left, -1):
            arr[j] = arr[j - 1]

        arr[left] = key

    return arr
한 줄씩 따라가기. 정렬된 부분은 인덱스 0부터 i - 1까지라 left, right = 0, i - 1로 탐색 범위를 잡는다. mid는 범위의 가운데다. 가운데 값이 key보다 크면 key의 자리는 그보다 왼쪽이니 right를 mid - 1로, 아니면(같은 값 포함) 오른쪽이니 left를 mid + 1로 좁힌다. 범위가 엇갈려 반복이 끝나면 left는 「key보다 큰 값이 처음 나오는 자리」를 가리키므로 그곳이 삽입 위치다. 같은 값이면 오른쪽으로 보냈기 때문에 같은 값 뒤에 들어가 안정 정렬이 유지된다. for j in range(i, left, -1):은 j를 i부터 left + 1까지 하나씩 줄이며 arr[j - 1]을 arr[j]로 민다 — 오른쪽 끝부터 밀어야 아직 안 옮긴 값을 덮어쓰지 않는다. 마지막에 빈 arr[left]에 key를 넣는다.
장점: 비교 횟수 O(n log n)으로 감소 — key 하나의 자리를 찾는 데 범위를 반씩 줄이므로 log i번이면 되고, 이것을 n개에 하면 대략 n log n이다
단점: 여전히 이동은 O(n²)이므로 전체 성능 개선은 제한적
2. 셸 정렬 (Shell Sort)
셸 정렬은 삽입 정렬의 개선된 버전으로, 멀리 떨어진 원소들을 먼저 정렬한다.
def shell_sort(arr):
    """
    셸 정렬: 삽입 정렬의 일반화
    간격을 점점 줄여가며 삽입 정렬 수행
    """
    n = len(arr)
    gap = n // 2

    while gap > 0:
        # gap 간격으로 삽입 정렬
        for i in range(gap, n):
            temp = arr[i]
            j = i

            while j >= gap and arr[j - gap] > temp:
                arr[j] = arr[j - gap]
                j -= gap

            arr[j] = temp

        gap //= 2

    return arr
한 줄씩 따라가기. gap은 처음에 배열 길이의 절반이다. 안쪽 코드는 기본 삽입 정렬과 같은데, 바로 왼쪽(j - 1)이 아니라 gap만큼 왼쪽(j - gap)과 비교하고 gap칸씩 민다. 즉 gap만큼 떨어진 원소들끼리만 삽입 정렬을 한다. 한 바퀴가 끝나면 gap //= 2로 간격을 반으로 줄이고, 마지막 gap = 1일 때는 보통의 삽입 정렬과 똑같아진다.
왜 빨라지는가. 보통 삽입 정렬은 한 번에 한 칸씩만 밀기 때문에, 맨 뒤에 있는 작은 값을 맨 앞으로 보내려면 n번 가까이 밀어야 한다. 셸 정렬은 큰 간격에서 그런 값을 한 번에 멀리 옮겨 둔다. 그래서 마지막 gap = 1 바퀴가 받는 데이터는 이미 거의 정렬돼 있고, 앞에서 본 대로 삽입 정렬은 거의 정렬된 데이터에서 빠르다.
성능: 평균 O(n log n) ~ O(n^1.5), 최악 O(n²)
표(「다른 정렬 알고리즘과 비교」)에는 최선 칸에 O(n log n), 평균 칸에 O(n^1.5)를 적었다. 이미 정렬된 입력이면 바퀴마다 비교가 n번쯤으로 끝나고 바퀴가 log n개라 O(n log n)이 최선이고, 평균은 간격 방식에 따라 그 사이 어딘가다. O(n^1.5)는 n의 1.5제곱이다. n²보다는 천천히, n log n보다는 빨리 커진다. 셸 정렬의 성능은 간격을 어떻게 줄이느냐에 따라 달라지고, 이 값들을 이 글에서 증명하지는 않았다. 위 코드처럼 반씩 줄이는 방식은 최악에 O(n²)이 된다.
언제 사용해야 할까?
적합한 경우
- 데이터가 작을 때 (10~50개)
- 데이터가 거의 정렬되어 있을 때
- 안정 정렬이 필요할 때
- 온라인 정렬이 필요할 때
- 간단한 구현이 필요할 때
- 하이브리드 알고리즘의 일부로 사용
부적합한 경우
- 대용량 데이터 (1000개 이상 — 10~50개와 마찬가지로 흔히 드는 기준이고, 직접 재 보지는 않았다)
- 완전히 무작위 또는 역순 데이터
- 성능이 중요한 대규모 시스템
다른 정렬 알고리즘과 비교
| 알고리즘 | 최선 | 평균 | 최악 | 공간 | 안정성 | 특징 |
|---|---|---|---|---|---|---|
| 삽입 정렬 | O(n) | O(n²) | O(n²) | O(1) | 안정 | 거의 정렬된 데이터에 강함 |
| 선택 정렬 | O(n²) | O(n²) | O(n²) | O(1) | 불안정 | 교환 횟수 적음 |
| 버블 정렬 | O(n) | O(n²) | O(n²) | O(1) | 안정 | 가장 느림 |
| 셸 정렬 | O(n log n) | O(n^1.5) | O(n²) | O(1) | 불안정 | 삽입 정렬의 개선 |
| 퀵 정렬 | O(n log n) | O(n log n) | O(n²) | O(log n) | 불안정 | 평균 가장 빠름 |
| 병합 정렬 | O(n log n) | O(n log n) | O(n log n) | O(n) | 안정 | 안정적 성능 |
| 힙 정렬 | O(n log n) | O(n log n) | O(n log n) | O(1) | 불안정 | 공간 효율적 |
표를 읽는 데 필요한 것을 덧붙인다.
- 버블 정렬이 「가장 느림」인 이유 — 복잡도는 삽입 정렬과 같지만, 비교가 평균 n²/2로 삽입 정렬(n²/4)의 두 배이고 한 번의 맞바꾸기가 한 칸 밀기보다 일이 많다(앞의 「다른 O(n²) 정렬과의 비교」)
- 퀵 정렬 · 병합 정렬 · 힙 정렬 — 셋 다 평균 O(n log n)인 정렬이다. 뜻은 각 용어 페이지에 있다
- 셸 · 퀵 · 힙 정렬이 불안정한 이유 — 셋 다 멀리 떨어진 두 칸 사이에서 값을 옮긴다. 셸 정렬은
gap만큼 떨어진 원소끼리 정렬하는데, 같은 값 두 개가 서로 다른 묶음에 들어가 있으면 한쪽만 멀리 옮겨지면서 다른 쪽을 건너뛸 수 있다. 퀵 정렬은 나눌 때 피벗 양쪽의 먼 칸끼리 맞바꾸고, 힙 정렬은 맨 위 값을 배열 끝과 맞바꾼다. 앞에서 본 선택 정렬의[5a, 5b, 2]처럼, 먼 칸끼리 옮길 때 같은 값의 순서가 뒤집힐 수 있다 - 퀵 정렬의 공간 O(log n) — 퀵 정렬은 제자리에서 나누지만, 메서드를 부르면 그 메서드의 지역 변수와 「끝나면 돌아갈 자리」가 스택이라는 메모리 영역에 한 칸씩 쌓이고, 메서드가 끝나야 빠진다. 재귀는 끝나기 전에 또 부르므로 칸이 계속 쌓인다. 반씩 나뉘면 그 깊이가 log n이라 그만큼의 메모리를 쓴다
- 병합 정렬의 공간 O(n) — 정렬된 두 반쪽을 합칠 때 원래 크기만큼의 보조 배열이 필요해서다
실전 문제 연습
삽입 정렬은 코딩 테스트에서 직접 구현하거나 원리를 응용하는 문제로 나온다.
예제 문제
- 링크드 리스트 삽입 정렬: 연결 리스트를 삽입 정렬로 정렬
- 역순 쌍 개수: 삽입 정렬 과정에서 역순 쌍(inversion) 개수 계산. 역순 쌍은 「앞에 있는데 뒤의 값보다 큰」 두 원소의 쌍이다
- K번째 삽입 후 상태: K번째 원소 삽입 후 배열 상태 출력
아래 코드는 2번과 3번을 푸는 데 쓰는 두 함수다.
def insertion_sort_with_steps(arr):
    """정렬 과정을 출력하는 삽입 정렬"""
    n = len(arr)
    print(f"초기 상태: {arr}")

    for i in range(1, n):
        key = arr[i]
        j = i - 1

        print(f"\n{i}회차: key = {key}")

        # 적절한 위치 찾기
        moves = 0
        while j >= 0 and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1
            moves += 1

        arr[j + 1] = key

        if moves > 0:
            print(f"  → {moves}번 이동하여 인덱스 {j+1}에 삽입")
        else:
            print(f"  → 이동 없음 (이미 정렬된 위치)")

        print(f"  결과: {arr}")

    return arr


def count_inversions_insertion_sort(arr):
    """
    삽입 정렬을 이용한 역순 쌍 개수 계산
    역순 쌍: arr[i] > arr[j]인데 i < j인 경우
    """
    inversions = 0
    n = len(arr)

    for i in range(1, n):
        key = arr[i]
        j = i - 1

        while j >= 0 and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1
            inversions += 1  # 이동할 때마다 역순 쌍 발견

        arr[j + 1] = key

    return inversions, arr


# 실행 예시
print("=== 정렬 과정 ===")
numbers = [5, 3, 8, 4, 2]
insertion_sort_with_steps(numbers.copy())

print("\n=== 역순 쌍 개수 ===")
numbers2 = [5, 3, 8, 4, 2]
count, sorted_arr = count_inversions_insertion_sort(numbers2.copy())
print(f"역순 쌍 개수: {count}")
print(f"정렬된 배열: {sorted_arr}")
한 줄씩 따라가기. 두 함수 모두 기본 버전에 세는 변수 하나를 더한 것이다. insertion_sort_with_steps는 회차마다 몇 번 밀었는지(moves)와 그 회차가 끝난 배열을 찍는다 — K번째 회차의 「결과」 줄이 3번 문제의 답이다. count_inversions_insertion_sort는 민 횟수를 전부 더해 돌려준다. 한 번 밀 때마다 「key보다 앞에 있는데 key보다 큰 값」 하나를 key 뒤로 넘기는 것이므로, 그 한 번이 곧 역순 쌍 하나다. 그래서 민 횟수의 합이 역순 쌍 개수가 된다. return inversions, arr로 두 값을 같이 돌려주고, 호출하는 쪽은 count, sorted_arr = ...로 나눠 받는다. numbers.copy()로 복사본을 넘기는 이유는 함수가 넘겨받은 리스트를 직접 고치기 때문이다 — 원본 numbers를 그대로 남겨 두려는 것이다.
실행하면 이렇게 나온다.
=== 정렬 과정 ===
초기 상태: [5, 3, 8, 4, 2]

1회차: key = 3
  → 1번 이동하여 인덱스 0에 삽입
  결과: [3, 5, 8, 4, 2]

2회차: key = 8
  → 이동 없음 (이미 정렬된 위치)
  결과: [3, 5, 8, 4, 2]

3회차: key = 4
  → 2번 이동하여 인덱스 1에 삽입
  결과: [3, 4, 5, 8, 2]

4회차: key = 2
  → 4번 이동하여 인덱스 0에 삽입
  결과: [2, 3, 4, 5, 8]

=== 역순 쌍 개수 ===
역순 쌍 개수: 7
정렬된 배열: [2, 3, 4, 5, 8]
이동 횟수 1 + 0 + 2 + 4 = 7이 역순 쌍 개수 7과 같다. 손으로 세어도 (5,3) (5,4) (5,2) (3,2) (8,4) (8,2) (4,2)로 7개다.
링크드 리스트 삽입 정렬
class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next


def insertion_sort_linked_list(head):
    """
    연결 리스트를 삽입 정렬로 정렬
    """
    if not head or not head.next:
        return head

    # 더미 노드 생성
    dummy = ListNode(0)
    current = head

    while current:
        # 다음 노드 저장
        next_node = current.next

        # 삽입 위치 찾기
        prev = dummy
        while prev.next and prev.next.val < current.val:
            prev = prev.next

        # 삽입
        current.next = prev.next
        prev.next = current

        current = next_node

    return dummy.next
한 줄씩 따라가기. ListNode는 값(val)과 다음 노드를 가리키는 참조(next)만 가진 연결 리스트의 노드다. __init__은 생성자이고, val=0, next=None은 아무것도 안 넘기면 값 0, 다음 노드 없음으로 만든다는 기본값이다. if not head or not head.next:는 「리스트가 비었거나(head가 None) 노드가 하나뿐이면」 정렬할 것이 없으니 그대로 돌려준다는 뜻이다. dummy는 정렬된 리스트의 맨 앞에 가짜로 붙여두는 더미 노드로, 실제 값은 쓰지 않고 “여기서부터 정렬된 리스트가 시작한다”는 자리만 잡아준다. 바깥의 while current:는 원래 리스트를 하나씩 따라가며 current를 꺼내는데, 그 전에 next_node에 다음 노드를 미리 저장해 둔다 — 아래에서 current.next를 다시 연결하면 원래 다음 노드를 잃어버리기 때문이다. 안쪽의 while prev.next and prev.next.val < current.val:는 정렬된 부분을 dummy부터 따라가며 current보다 작은 값이 이어지는 동안 prev를 한 칸씩 옮긴다. 그 자리를 찾으면 current.next = prev.next와 prev.next = current로 current를 그 사이에 끼워 넣는다. 마지막에 current = next_node로 아까 저장해 둔 다음 노드로 넘어가 같은 과정을 반복한다. 다 끝나면 dummy는 가짜 노드이므로 dummy 자신이 아니라 그 다음인 dummy.next가 정렬된 리스트의 진짜 첫 노드다. 그래서 return dummy.next를 한다.
마무리
삽입 정렬은 단순하지만 실용적인 정렬 알고리즘이다. 특히 거의 정렬된 데이터나 작은 데이터셋에서 빠르고, 실제로 많은 고급 정렬 알고리즘에서 보조 알고리즘으로 쓰인다.
핵심 요약
- 정렬된 부분에 원소를 삽입하는 직관적인 알고리즘
- 시간 복잡도는 최선 O(n), 평균과 최악 O(n²)
- 안정 정렬이며 제자리 정렬
- 거의 정렬된 데이터에 효율적 (적응형, adaptive)
- 실무에서 하이브리드 알고리즘의 일부로 활용
- 온라인 정렬 가능 (데이터를 받으면서 정렬)
삽입 정렬을 이해했다면, 다음 단계로 이것들을 공부하는 것을 추천한다.
- 셸 정렬(Shell Sort): 삽입 정렬의 개선 버전
- 병합 정렬(Merge Sort): 안정적인 O(n log n) 알고리즘
- 퀵 정렬(Quick Sort): 평균적으로 가장 빠른 O(n log n) 알고리즘
- Timsort: Python의 기본 정렬 알고리즘 (삽입 정렬 + 병합 정렬)
참고 자료
- 위키백과 - 삽입 정렬
- VisuAlgo - 정렬 시각화
- Introduction to Algorithms (CLRS — 저자 Cormen · Leiserson · Rivest · Stein 네 사람의 머리글자로 부르는 알고리즘 교과서)
- GeeksforGeeks - Insertion Sort
- Timsort - Python의 기본 정렬
자신만의 철학을 만들어가는 중입니다.



댓글남기기